Dalla gestione delle persone alla gestione del flusso: un cambio di paradigma con effetti su scalabilità, AI, qualità e crescita manageriale

Pochi giorni fa, durante l’Officina del Kanban, una persona mi ha chiesto più volte perché dovrebbe dotarsi di metriche. Aveva costruito il suo sistema Kanban con cura e non ne sentiva il bisogno. Le ho chiesto a mia volta come fa a sapere quando il lavoro viene consegnato e la risposta è stata semplice: lei lo sa già, perché assegna il lavoro a ciascuno dei membri del team, e sono loro a comunicarle quando consegnano. Sono bravi e affidabili, quindi si fida di ciò che dicono.

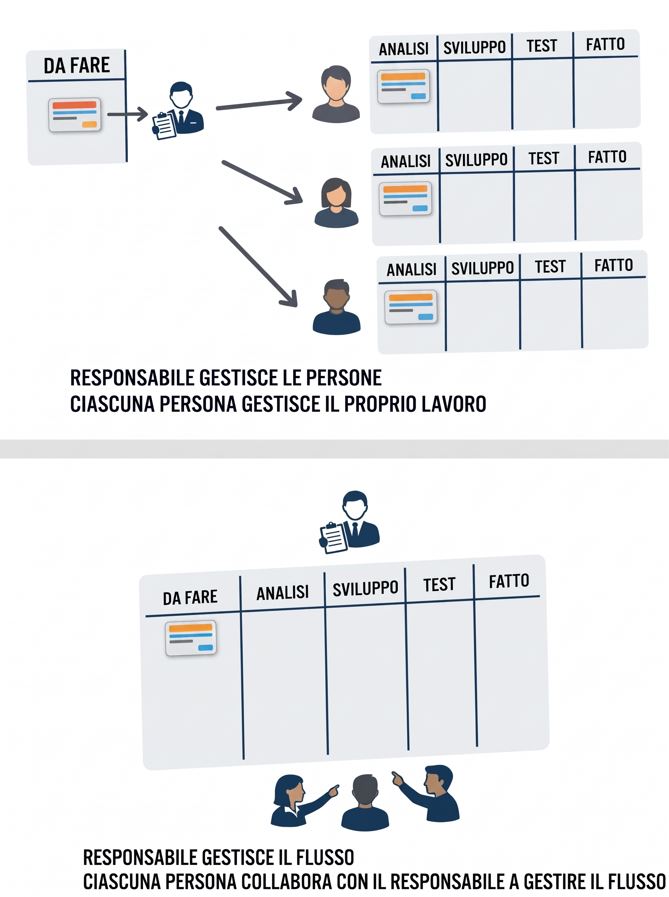
Questa risposta mi ha fatto capire la reale situazione. Quella persona gestisce le persone e non il flusso, e il passaggio dall’una all’altra gestione è esattamente ciò che nel Kanban Maturity Model (KMM) separa il livello di maturità 0 dal livello 1. L’immagine che accompagna l’articolo ne mostra i due estremi.
Un sistema che regge finché le persone restano

Nella parte alta dell’immagine il lavoro da fare arriva al responsabile, che lo assegna alle persone, e ciascuna lo gestisce per conto proprio. Ognuno può avere la sua Kanban board, ma in pratica funziona come un’azienda indipendente. Una volta l’ho detto a un imprenditore che mi descriveva questo modo di lavorare: hai un’azienda di dieci persone, ma è come se avessi dieci aziende che lavorano in parallelo. Le persone non sanno cosa fanno le altre, quindi non esiste un vero lavoro di squadra, e il responsabile gestisce le persone più che il lavoro.

Finché le persone sono brave il sistema produce risultati, ed è per questo che chi lo adotta non sente la necessità di cambiare. Il suo limite è che dipende interamente dalle persone, e questo lo rende fragile. Una settimana di ferie ferma il lavoro di chi è assente, perché nessun altro lo ha in mano. Un’influenza lo rallenta e le dimissioni lo bloccano del tutto. Per lo stesso motivo il sistema scala con difficoltà: per crescere serve un altro collaboratore bravo, e finché non arriva l’organizzazione non cresce.

Torno così alla domanda sulle metriche. La fiducia nei singoli membri del team è ben riposta finché restano loro. Se uno si dimette e ne arriva un altro, quella fiducia non c’è ancora, e per costruirla occorre rilevarne le misure, che cambiano da persona a persona. Le metriche servono quindi in ogni caso, anche se in un sistema di questo tipo si fatica a percepirne il bisogno.

Gestire il flusso

Nella parte bassa dell’immagine la situazione cambia. La board è una sola, il responsabile gestisce il flusso e ciascuna persona collabora con lui per farlo avanzare. Non esistono più il lavoro mio, il lavoro tuo e quello di un altro, perché il lavoro è condiviso e ognuno ne è in parte corresponsabile. Il responsabile resta il titolare dell’accountability, ma ora il lavoro attraversa una sorta di catena di montaggio, una filiera intorno alla quale le persone si organizzano.

Nel KMM questo percorso si sviluppa in più tappe. A ML1 nasce il team, perché le persone iniziano a collaborare sugli stessi compiti. A ML2 compare il ruolo di Flow Manager, cioè di chi presidia il flusso: raccoglie le metriche, fa rispettare i limiti al lavoro in corso e facilita la risoluzione dei blocchi. Come ho descritto nell’articolo Come funziona Kanban: il Flow Manager per migliorare la gestione del flusso di lavoro, è un ruolo da svolgere più che un titolo: può assumerlo il responsabile, oppure un membro del team che si è offerto e ha le competenze adatte.

Un sistema meno fragile e più scalabile

Il sistema che ne risulta è meno fragile. Quando una persona manca, anche solo per un periodo, le altre possono prendere in carico il suo lavoro, perché in parte lo hanno già in carico. È anche più scalabile, perché chi arriva si inserisce in un sistema che procede da solo e ha una propria fisionomia, e contribuisce a gestire il lavoro senza doversi organizzare un flusso proprio.

C’è poi un’altra ragione. In un sistema così le persone più brave, che prima svolgevano il lavoro, possono evolvere e fare il jolly: non prendono lavoro in carico direttamente, ma si muovono su tutto il flusso e aiutano gli altri, in particolare i più junior, a crescere e a lavorare bene. Così chi arriva trova qualcuno che lo accompagna, e l’organizzazione può crescere senza aspettare un altro collaboratore già esperto.

Un sistema che forma nuovi manager

Si dice spesso che per crescere una persona debba diventare manager. Di frequente, però, la promozione si riduce a un nuovo titolo sul biglietto da visita, senza che nessuno le insegni il mestiere del manager.

Un sistema che evolve da ML0 a ML3 offre un’alternativa. Le persone che si vogliono far crescere imparano il mestiere lavorando con gli strumenti del flusso: leggono le metriche, gestiscono i limiti al lavoro in corso, facilitano la risoluzione dei blocchi. Quando poi diventano responsabili o assumono il ruolo di Flow Manager, quel mestiere lo conoscono già. Gestire il flusso non toglie spazio alle persone: è il modo in cui si insegna loro a diventare manager.

L’effetto sull’intelligenza artificiale

Il passaggio dalla gestione delle persone alla gestione del flusso ha una conseguenza anche sull’uso dell’intelligenza artificiale. Quando i flussi sono tanti quante sono le persone, le attività si duplicano. Se per esempio ciascuno fa la propria analisi e se la ottimizza con l’AI, lo stesso lavoro viene ripetuto molte volte. L’AI consuma token e il costo dipende proprio da quelli, per cui in un’azienda di qualche decina di persone che ripetono la stessa operazione il costo si moltiplica per il numero di persone coinvolte. Con un flusso unico l’analisi è una sola, e se serve l’AI la si applica lì.

Un flusso unico rende anche visibile il collo di bottiglia. Con tanti flussi i colli di bottiglia sono altrettanti e dipendono dalle persone, per cui non si capisce dove intervenire. Quando invece il collo di bottiglia è individuato, l’AI trova la sua collocazione corretta. Se la si mette a monte, intasa ancora di più il collo di bottiglia. Se la si mette a valle, si spreca la sua potenzialità, perché non si accelera nulla che sia già scarico.

C’è infine una possibilità in più. In un flusso unico si può provare a usare l’AI come attore del team, un agente che lavora con le persone, aiuta a orchestrare il flusso e a renderlo più efficiente. Dove il flusso non esiste però, non c’è nulla da orchestrare.

L’effetto sulla qualità

Un’ulteriore conseguenza riguarda la qualità. Dove il responsabile gestisce le persone, la qualità dipende da a chi viene assegnato il lavoro: se arriva a una persona brava il risultato è buono, se arriva a una meno brava lo è meno. Quando si passa a gestire il flusso, la qualità tende a dipendere sempre meno dalle singole persone e sempre più dal modo in cui il flusso funziona.

Avviene gradualmente man mano che il sistema evolve. A ML2 il risultato dipende ancora dall’impegno eroico dei manager. A ML3 la qualità non è più legata né agli eroismi individuali né a quelli manageriali, ma a una gestione del flusso consistente. Le persone continuano a essere più o meno brave, ma è il sistema nel suo insieme a determinare il risultato.

Perché le metriche servono sempre

Tornando alla persona dell’Officina, la sua fiducia nei singoli membri del team è giustificata finché sono loro a lavorare, ma non si trasferisce a chi arriva dopo. Le metriche servono comunque, e cambia solo il motivo. In un sistema che gestisce le persone servono per decidere se fidarsi di ciascuna, in un sistema che gestisce il flusso servono per gestirlo.

Conclusione

Il passaggio dalla gestione delle persone alla gestione del flusso è un cambio di paradigma organizzativo, non una questione di strumenti. Si parte da ML0, dove il responsabile assegna il lavoro e ciascuno se lo gestisce. A ML1 nasce il team e il responsabile smette di gestire le persone per occuparsi del flusso, a ML2 questo presidio diventa il ruolo di Flow Manager e a ML3 la qualità dipende dal flusso e non più dagli eroismi di persone o manager.

Le conseguenze sono concrete. Il sistema è meno fragile e più scalabile, perché il lavoro è condiviso e non dipende più da una sola persona. L’AI non viene duplicata da ciascuno per supportare le proprie attività ma si applica una volta sola, nel punto in cui il flusso ne ha bisogno. La qualità smette di dipendere da a chi viene assegnato il lavoro. Infine il sistema non rende le persone meno importanti: è il modo in cui si insegna loro il mestiere del manager, invece di limitarsi a promuoverle. Per migliorare non basta chiedersi quanto siano bravi i singoli: serve capire come funziona il flusso in cui lavorano e dare loro gli strumenti per poterlo gestire efficacemente.

Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti.
Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.
ITIL5 e le metriche del ciclo di vita: dove entra Kanban e dove serve l’intelligenza artificiale

Ho appena terminato di tenere un corso ITIL 5 Foundation. Mentre raccontavo le otto attività del nuovo ciclo di vita dei prodotti e dei servizi, a ciascuna era associato un elenco di metriche di successo, e continuavo a vedere passare metriche che conosco molto bene: sono quelle tipiche dei sistemi Kanban. Avrei voluto fermarmi a raccontare cosa dice il Kanban Maturity Model (KMM) su quelle misure. Chi segue un corso come questo spesso vorrebbe anche capire come si fa nella pratica, ma un corso ITIL deve attenersi al contenuto dell’esame e non è il luogo per approfondire la parte pratica. Allora provo a farlo in questo articolo, almeno per dare qualche spunto.

Un secondo punto mi ha fatto riflettere durante il corso. ITIL 5 collega l’intelligenza artificiale alla visione olistica, quella che in Kanban chiamiamo visione sistemica (Systems Thinking), e all’individuazione dei colli di bottiglia, e dice che i miglioramenti del flusso vanno concentrati proprio lì. È un buon punto di partenza. Io ci aggiungo dove applicarla concretamente: a monte del collo di bottiglia intasa ancora di più, a valle accelera qualcosa che non ne ha bisogno. In aula ho fatto un breve accenno al concetto, qui vorrei provare a spiegarlo meglio.

Cosa introduce ITIL 5

ITIL 5 introduce un modello di ciclo di vita di prodotti e servizi digitali con otto attività: Discover, Design, Acquire, Build, Transition, Operate, Deliver, Support. ITIL precisa che non vanno eseguite come un ciclo: dal punto di vista dell’organizzazione formano la catena del valore, cioè l’insieme delle attività che abilitano il valore. Ogni organizzazione ne include alcune o tutte e le combina, secondo il proprio contesto, nei flussi del valore (value stream).

La novità rispetto a ITIL 4 è che a ciascuna attività è associato un elenco di metriche chiave di successo. In ITIL 4 le metriche stavano nelle pratiche. Cycle time, wait time e lead time c’erano già, ma a livello di flusso e di pratiche, non di attività.

Guardando l’insieme delle metriche, alcune saltano all’occhio. La soddisfazione compare in tutte e otto le attività: quella degli stakeholder in sette, quella di clienti e utenti in Deliver e in Support. L’aderenza alla roadmap o alla strategia in sette. Un tempo esplicito compare in quattro: Design, Acquire, Build e Transition, a cui si aggiunge la velocità di ripristino in Support. Discover, Operate e Deliver non hanno nessuna metrica di tempo.

Le metriche e il Kanban Maturity Model

Le corrispondenze con il KMM sono molte.

Per la transizione ITIL misura il numero e l’impatto degli errori di transizione, cioè dei rilasci andati male. Un rilascio andato male genera rilavorazioni, e il lavoro che ne nasce nel KMM si chiama failure demand: la domanda che arriva perché la qualità iniziale non bastava.

Per la qualità ITIL misura specifiche, risorse e soluzioni. Nel KMM la qualità si misura sul risultato finale: la quota di richieste consegnate senza rilavorazione. Quando si registra una rilavorazione, occorre risalire a quali specifiche, risorse o soluzioni l’hanno generata.

Per Deliver e Support ITIL misura la performance rispetto agli SLA concordati. Nel KMM corrispondono la puntualità di consegna e gli impegni di servizio basati sui percentili di lead time.

Per la soddisfazione di stakeholder, clienti e utenti ITIL ha una misura in ogni attività. Nel KMM corrispondono gli indicatori di fitness for purpose, ricavati dai criteri con cui il cliente sceglie il servizio.

Poi in ITIL troviamo le metriche di tempo: design cycle time, acquire cycle time, building cycle, transition cycle e velocità di ripristino. Nel KMM le grandezze corrispondenti sono lead time e cycle time, che si leggono come percentili sulle rispettive curve di distribuzione.

Cosa ITIL 5 dice sul livello operativo

ITIL 5 fornisce la cornice concettuale, il modello di ciclo di vita e i principi guida per orientare le decisioni, e lascia il dettaglio delle procedure operative ad altre fonti: le ITIL Practice Guide ufficiali, DevOps, PRINCE2 per il project management. Lo stesso ITIL dichiara che nessun framework da solo basta. Tratta anche il flusso, con la mappatura dei flussi del valore, e usa le metriche di tempo per individuare colli di bottiglia e ritardi.

Su Kanban dice due cose. Lo definisce come un metodo per visualizzare il lavoro, individuare blocchi e conflitti di risorse e gestire il lavoro in corso. E cita le Kanban board tra gli strumenti per dare visibilità agli stakeholder. Non compaiono né il funzionamento pull né i limiti al lavoro in corso. A mio avviso la rappresentazione che ITIL offre di Kanban è semplificata, come già scrivevo a proposito di ITIL 4: il metodo è molto più ricco.

Io propongo Kanban per governare e gestire i flussi. Per governare i flussi intendo applicare le pratiche e i principi del metodo Kanban, come specificati nel Kanban Maturity Model. Nel KMM il verbo governare si riferisce alle policy, che regolano il comportamento di persone e team, mentre il flusso di lavoro si gestisce. Io uso i due verbi insieme: le policy governano, e il lavoro scorre e si gestisce dentro quei confini.

Dalle metriche alla pratica

Prendiamo per esempio i rilasci andati male. In ITIL si misura il numero e l’impatto degli errori di transizione. In Kanban ragioniamo per work item, che attraversano il flusso. Se un work item arriva al rilascio e il rilascio va male, viene conteggiato e nasce un nuovo work item, marcato come failure demand: un rifacimento di qualcosa che era già stato fatto. Così facendo sappiamo in ogni momento quanta percentuale complessiva del lavoro è costituita da rilavorazioni.

Quanto possono pesare in percentuale le rilavorazioni? In Kanban: Successful Evolutionary Change for Your Technology Business, David Anderson riporta il caso di un team che spendeva il 90% della capacità disponibile nella correzione di difetti. Un flusso così è intasato da lavoro che nasce da lavoro già fatto male, e le nuove richieste aspettano.

Nelle organizzazioni più mature le rilavorazioni contano contro il limite del lavoro in corso: se ce ne sono troppe, non entra nuovo lavoro finché i problemi di qualità non sono stati risolti. I dati su difetti e rilavorazioni si guardano poi nelle revisioni periodiche, dove si decide cosa fare per ridurli.

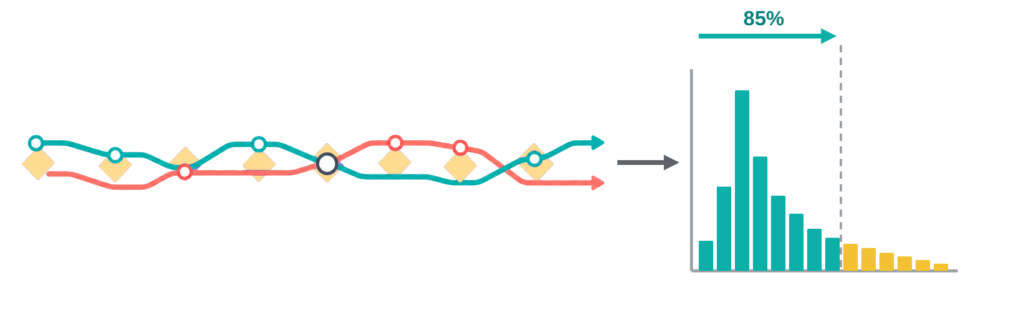
Passiamo alla performance rispetto agli SLA concordati. In Kanban lo SLA si costruisce partendo dai dati: si misurano i lead time dei lavori consegnati e se ne costruisce la curva di distribuzione. Dalla curva si leggono i percentili e, in base al percentile opportuno, si definisce la service level expectation (SLE): entro quanti giorni consegno e in quale percentuale di casi. L’85° percentile è il riferimento abituale, ma non è una regola: se un ritardo costa molto, conviene salire. Sulla base dello SLE definito si concorda lo SLA con il cliente in modo realistico.

Le metriche di tempo che ITIL associa alle attività, cioè design cycle time, acquire cycle time, building cycle e transition cycle, misurano ciascuna un singolo passaggio. ITIL ha poi una misura dell’intero flusso del valore, il lead time, dall’avvio alla consegna, e indica le otto attività come un buon punto di partenza per mappare i flussi. ITIL non dice però da dove parta il lead time.

Il KMM lo precisa, e parla dello stesso oggetto: quello che ITIL chiama flusso del valore, nel KMM è il workflow. Il customer lead time parte dalla richiesta accettata del cliente, il system lead time dalla presa in carico del lavoro da parte del team, ed entrambi arrivano alla consegna. Quando si applica Kanban si misurano sia le metriche end to end sia quelle dei singoli passaggi, e anche le attese, e in base a queste misure si ragiona su come ottimizzare il flusso.

Un passaggio può avere un buon tempo di ciclo e il cliente aspettare comunque a lungo, perché nel tempo di ciclo non ci sono le attese tra un passaggio e l’altro. L’esperienza dice che le attese sono la parte prevalente del lead time, e di diversi casi ho scritto anche su questo blog. Per questo si lavora sulle attese: limitando il lavoro in corso, riducendo code e buffer, gestendo meglio blocchi e dipendenze.

Lo stesso vale per la velocità di ripristino del servizio, che in ITIL compare in Support. È il lead time della gestione degli incidenti, e come ogni altra metrica di tempo si misura con la distribuzione, si legge con i percentili e si trasforma in uno SLE.

Resta la soddisfazione di stakeholder, clienti e utenti, che ITIL misura in tutte e otto le attività. Nel KMM non la si misura chiedendola in astratto. Si parte dai criteri con cui il cliente decide se richiedere il servizio, o dalle fonti della sua insoddisfazione, e da lì si ricavano gli indicatori da misurare: tempi di consegna per classe di servizio, quota di richieste consegnate senza rilavorazione, costo.

È quello che facciamo in continuazione con le aziende con cui collaboro. Partiamo dalle fonti di insoddisfazione, che mi raccontano i clienti. Quando abbiamo messo a posto il servizio, verifichiamo se quelle fonti sono state risolte. Gli indicatori non sono necessariamente solo quelli classici di Kanban: dalle fonti di insoddisfazione possono emergere altri aspetti da misurare, e li misuriamo. In questo modo la fitness for purpose diventa la sintesi di tutte le metriche, classiche e no.

L’intelligenza artificiale: dove serve e dove no

ITIL 5 dedica molto spazio all’intelligenza artificiale, e la collega alla visione olistica e all’individuazione dei colli di bottiglia. Dice anche di concentrare i miglioramenti del flusso proprio sui colli di bottiglia, e di ottimizzare il flusso prima di automatizzarlo. È un buon punto di partenza.

Una volta definito il flusso, si misura e si individua il collo di bottiglia, ed è lì che va applicata l’AI. Se la si applica a monte, il lavoro si accumula davanti al collo di bottiglia e il lead time peggiora. Se la si applica a valle, il lead time non cambia in modo apprezzabile, e può essere anche uno spreco: si accelera una stazione di lavoro che è già più scarica del collo di bottiglia. Prendiamo uno sviluppo software: se l’AI fa scrivere il codice più in fretta, ma il collo di bottiglia, a monte, è la risposta del cliente sui requisiti poco chiari, il lavoro accelerato resta in attesa. Non è cambiato nulla.

C’è poi un secondo ragionamento. Spesso il lavoro è fatto per lo più di attese, e accelerare il lavoro effettivo, come fa l’AI quando velocizza un compito, cambia poco il lead time. Ne ho scritto in un articolo recente, e lì la domanda diventa un’altra: come usare l’AI per ridurre le attese.

Conclusione

Sono partito da ITIL 5, che dice cosa misurare per ciascuna attività del ciclo di vita e rimanda ad altre fonti per il dettaglio operativo. Io propongo Kanban per governare e gestire i flussi, e le metriche sono il punto da cui si comincia. I rilasci andati male diventano failure demand, gli SLA nascono dalla distribuzione dei lead time, la soddisfazione si ricava dalle fonti di insoddisfazione di chi usa il servizio, e le metriche di tempo si leggono su tutto il flusso, non solo su un singolo passaggio.

Anche per l’intelligenza artificiale vale lo stesso ragionamento: serve dove c’è il collo di bottiglia, non dove il lavoro è già veloce. E resta necessario qualcuno che gestisca il sistema di lavoro, AI compresa.

Bibliografia

  1. ITIL® Foundation, Version 5, manuale ufficiale, e ITIL® (Versione 5) Glossario principale, v5.1, luglio 2026, PeopleCert.
  2. David J. Anderson, Teodora Bozheva, Kanban Maturity Model: A Map to Organizational Agility, Resilience, and Reinvention, 2nd Edition, Kanban University Press, 2021.
  3. David J. Anderson, Kanban: Successful Evolutionary Change for Your Technology Business, Blue Hole Press, 2010.

Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti.
Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.
Come funziona Kanban: dalla stima alla previsione, quando il fornitore sono io

Nell’articolo precedente ho raccontato come prendere le misure a un fornitore lento: misurare io il tempo che passa tra la mia richiesta e la sua risposta, quella che chiamo ‘metrica reciproca’, e regolarmi di conseguenza. Chiudevo con un’osservazione: il livello di servizio che dichiaro a valle deve tenere conto di quello che so del mio fornitore.

Resta però una domanda: quale livello di servizio dichiaro, io? Perché a valle il fornitore sono io. E il mio cliente, che io mi misuri o no, prima o poi la metrica reciproca la prende a me. Esattamente come io l’ho presa al mio fornitore.

Prendere le misure a me stesso

Quando un cliente chiede “per quando?”, di solito si tende a rispondere con una stima. Si guarda il lavoro, si valuta quanto è complicato, si pensa a com’è andata l’ultima volta e si ipotizza una data. È un’opinione, magari esperta, ma resta un’opinione. Una previsione funziona in un altro modo: non guarda il singolo lavoro, guarda come sono andati tutti i lavori simili. Non è un’opinione, è statistica.

Per fare questo lo strumento lo conosciamo già: è la stessa curva di distribuzione del Lead Time che ho costruito per il fornitore, solo che questa volta riguarda la parte del servizio che gestisco io. Con un’avvertenza su cosa misurare, perché è qui che ci si inganna più facilmente.

Il Kanban Maturity Model (KMM) distingue il Customer Lead Time, che parte da quando il cliente fa la richiesta, dal System Lead Time, che parte da quando io la prendo in carico. In mezzo c’è l’attesa all’ingresso: la richiesta è arrivata, ma nessuno ci sta ancora lavorando. Quell’attesa tendo a non vederla, perché per me il lavoro non è ancora cominciato. Il cliente invece la subisce per intero. Se misuro solo il System Lead Time, la mia previsione è strutturalmente ottimistica e il cliente aspetta sistematicamente più di quanto dicano i miei dati.

“I dati non li abbiamo”

Quando ne parlo nelle aziende arriva quasi sempre un’obiezione: “bello, ma i dati non li abbiamo”. In realtà ci sono quasi sempre, solo che non vengono usati. Ogni lavoro chiuso ha lasciato una traccia: una data in cui è stato chiesto e una in cui è stato consegnato, in un sistema di ticketing, in una mail, in un registro, a volte in un foglio Excel che qualcuno compila per abitudine. Non servono strumenti sofisticati per cominciare, serve la disciplina di raccogliere i dati. E, come abbiamo visto nel precedente articolo, se il sistema è stabile una trentina di misurazioni bastano per avere un primo quadro affidabile.

“Ma ogni lavoro è diverso”

La seconda obiezione che ricevo in azienda è più radicata: “il nostro lavoro non si presta, ogni cliente ha esigenze uniche, ogni progetto è un caso a sé”. È vero solo in parte. Il lavoro davvero unico esiste, ma è molto meno di quanto ci piace pensare. Il resto è fatto di attività che ripetiamo ogni settimana, solo che non le tracciamo, e quello che non vediamo ci sembra imprevedibile per definizione.

Di solito il lavoro non è tutto diverso: è di pochi tipi diversi. E i dati, curiosamente, lo mostrano da soli. Il KMM osserva che quando la distribuzione del Lead Time ha più picchi, in genere è perché dentro ci sono più tipi di lavoro mescolati. La risposta, quindi, non è rinunciare a misurare perché “tanto è tutto diverso”, ma separare i dati per tipo e costruire una curva per ciascuno. Tre o quattro tipi di lavoro diventano tre o quattro distribuzioni, e tre o quattro previsioni, ognuna sufficientemente affidabile per il suo tipo.

Dalla distribuzione allo SLE

Dalla distribuzione nasce il livello di servizio che posso dichiarare al cliente, lo SLE (Service Level Expectation): entro quanto tempo consegno, e in quale percentuale di casi. Perché sia una promessa e non un azzardo, però, servono due condizioni.

La prima è che la coda sia sottile, cioè che il rapporto tra il 98° percentile e la mediana stia sotto 5,6. Se la coda è grassa, qualunque numero dichiari è fragile: prima o poi arriva il caso che va lunghissimo e smentisce tutto. In quella situazione il primo lavoro non è promettere, è accorciare la coda statistica.

La seconda è scegliere il percentile giusto. L’85° è il riferimento comune per i servizi, sei volte su sette, ma non è una regola che vale sempre. Dipende da quanto costa al cliente un ritardo: se il ritardo costa molto, conviene salire.


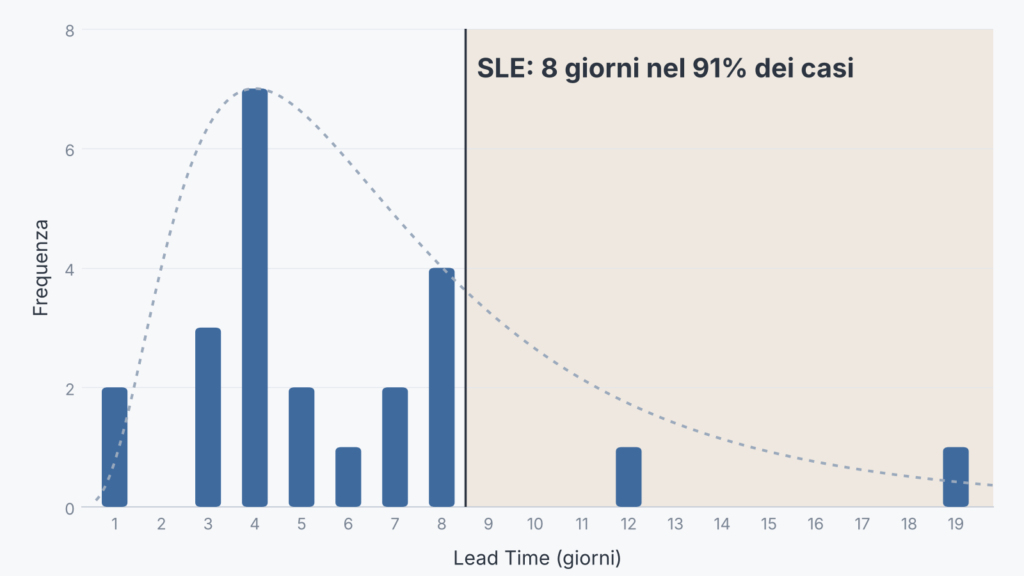
Distribuzione del Lead Time dell’onboarding dopo il primo mese

Un buon esempio di quanto descritto è il caso dell’onboarding di Grow, di cui parlo nell’articolo Migliora le tue risorse umane con Kanban: Kanban in HR – Scaling Kanban in an HR department at Grow (Italy) (case study in inglese). Quando abbiamo cominciato a misurare, il Lead Time andava da 1 a 96 giorni: una coda grassa, su cui nessuna promessa poteva essere affidabile. Non abbiamo dichiarato niente. Siamo intervenuti su uno dei colli di bottiglia, la firma digitale del contratto, e in un mese la coda si è accorciata fino a diventare sottile (19 giorni), con una distribuzione dei tempi di onboarding come nell’immagine. Solo a quel punto abbiamo dichiarato ai reparti richiedenti uno SLE: 8 giorni nel 91% dei casi.

Abbiamo tenuto il percentile più alto dell’85° perché un ritardo nell’onboarding non era un semplice disagio: significava persone al lavoro senza un contratto firmato, con il rischio di sanzioni. Lo stesso servizio, con un costo del ritardo più basso, avrebbe potuto reggersi su un percentile diverso.

Cosa vuole davvero il cliente

Si pensa spesso che il cliente voglia tutto e subito, e che l’unico modo per farlo contento sia promettere tempi brevi. In realtà quello che spesso cerca è un’altra cosa: risposte oneste e previsioni affidabili, con cui fare a sua volta le sue previsioni.

È il meccanismo dell’articolo precedente, visto dall’altra parte del tavolo. Il mio SLE diventa il dato su cui il mio cliente pianifica, esattamente come lo SLE del mio fornitore era il dato su cui pianificavo io. Una data detta con sicurezza, che poi slitta, magari più volte, non gli serve a niente: lo costringe a ripianificare ogni volta. Una previsione affidabile con una probabilità dichiarata invece gli permette di regolarsi. La catena regge solo se ogni anello è onesto e affidabile, e io sono uno degli anelli.

Conclusione

Non è vero, quindi, che non posso promettere niente di affidabile. Come minimo posso misurarmi, con gli stessi strumenti con cui misuro il fornitore, e sapere cosa posso dichiarare. Posso separare i tipi di lavoro invece di nascondermi dietro il “è tutto diverso”, accorciare la coda dove serve prima di promettere, e scegliere il percentile in base a quanto costa davvero un ritardo. E posso dare al mio cliente esattamente quello che io chiedo al mio fornitore: una previsione onesta.

Al giorno d’oggi, poi, c’è una nuova tentazione, più forte che mai: usare l’AI e lasciare che sia lei a fare le previsioni al posto nostro. Ma se il lavoro non è tracciato, l’AI una risposta la dà comunque, sicura e ben presentata, solo che non ha fondamento. È una stima come quella descritta più sopra, ma quando esce da un sistema automatico con un numero e un grafico, smette di sembrare un’opinione e nessuno la mette più in discussione. Decidere cosa misurare e come resta una scelta umana, come ho spiegato nell’articolo Perché collegare l’AI ai vostri dati di flusso non basta.

Quest’ultimo tema è così importante che ho deciso di dedicargli un podcast, che prenderà il via il prossimo mese di novembre. Restate sintonizzati!

Bibliografia

  1. David J. Anderson, Teodora Bozheva, Kanban Maturity Model: A Map to Organizational Agility, Resilience, and Reinvention – 2nd Edition, Kanban University Press, 2021

Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti.
Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.
Come funziona Kanban: se il fornitore è lento, non è vero che non posso farci niente

Una frase che mi capita spesso di sentire è più o meno questa: “Noi potremmo organizzarci meglio e rendere prevedibile il nostro lavoro, ma i tempi di certe operazioni dipendono dagli altri. Non possiamo farci niente.”

Ogni volta che l’ho sentita ho pensato che avrei dovuto scrivere questo articolo. Perché non è vero che non ci si può fare niente: si può fare qualcosa, e anche di abbastanza semplice.

Chiamo fornitore chiunque debba fare qualcosa per me senza che io ne abbia il controllo. Può essere un’azienda esterna, ma anche un collega di un’altra funzione.

Prima di tutto, misurare

Se dipendo da qualcuno che ci mette tanto tempo, la prima cosa da capire è cosa vuol dire quel “tanto”. Se il fornitore non mi dà le sue metriche, le prendo io: è quella che chiamo ‘metrica reciproca’. Misuro il tempo che passa da quando faccio la richiesta a quando ricevo la risposta, e lo faccio abbastanza a lungo da costruire una curva di distribuzione del Lead Time.

Non servono migliaia di dati. Se il fenomeno è consistente, cioè se i tempi restano più o meno sempre nello stesso range, siamo in quello che Taleb chiama Mediocristan. Il Kanban Maturity Model (KMM) offre una regola pratica per verificarlo: il rapporto tra il 98° percentile e la mediana deve stare sotto 5,6. In quel caso una trentina di misurazioni bastano per avere un quadro piuttosto affidabile.

Abbastanza spesso, a misure prese, scopro una cosa banale: il fornitore non è imprevedibile, è semplicemente più lento di quanto dichiara. E lo è in modo costante.

Decidere con i dati

Il riferimento abituale è l’85° percentile: sei volte su sette la risposta arriva entro quel tempo. Il KMM definisce il Lead Time proprio così: se so quando mi serve la consegna, il Lead Time è l’anticipo con cui devo fare l’ordine per aspettarmi di riceverla in tempo.

A questo punto confronto quel valore con il tempo di cui ho bisogno. Se la risposta mi serve più in là dell’85° percentile, la richiesta va in classe di servizio standard: la mando con il giusto anticipo e so che, storicamente, arriverà in tempo. È inutile sollecitare, ed è inutile sorprendersi ogni volta dei tempi lunghi. Li conosco.

Se invece mi serve prima, il rischio di andare lunghi è più alto di quello che posso permettermi, e la richiesta va segnalata come urgente. Più il tempo è stretto, più il rischio è alto, e la distribuzione mi dice esattamente quanto. L’urgenza però deve restare un’eccezione: se tutto arriva urgente, il fornitore smette di crederci. Per questo conviene giocare d’anticipo il più possibile.

Provare a pressare e poi misurare di nuovo

“Va bene, ma allora come facciamo?” A questo punto posso fare un esperimento: pressare il fornitore e vedere cosa succede alla distribuzione. Se si comprime e l’85° percentile rientra nel tempo che mi serve, ho trovato un pattern su cui contare: il pressing diventa strutturale e lo faccio di default. Se non si comprime, ho comunque imparato che quella leva non funziona.

In ogni caso devo continuare a misurare, perché il pressing cambia il sistema. E devo tenere a mente che, se i miei tempi si accorciano, forse sto solo passando davanti agli altri clienti del fornitore: io miglioro, il suo sistema no.

Le misure servono anche a valle. Se a mia volta devo garantire dei tempi a un cliente, interno o esterno, il mio livello di servizio atteso (SLE – Service Level Expectation) deve tenere conto di quello che so del mio fornitore. È inutile promettere cose che so già di non poter mantenere a causa di qualcun altro.

Un caso reale

Con un fornitore con cui c’è una buona collaborazione dovevamo chiudere un progetto. Il fornitore dichiarava di poter finire entro fine febbraio, e per farcela avrebbe dovuto rilasciare circa nove work item a settimana. Gli abbiamo preso le misure, ricostruendole da progetti passati: ne rilasciava tre, in modo piuttosto stabile.

Non potevamo triplicare il suo Throughput, così abbiamo triplicato il tempo e pianificato la consegna per fine aprile. A lui abbiamo continuato a indicare fine febbraio. Abbiamo misurato il Throughput e non il Lead Time, ma con un sistema stabile vale la Legge di Little e il risultato non cambia: circa tre mesi.

Il progetto si è chiuso, come previsto, a fine aprile. La scadenza più stretta non ha accelerato nulla: il fornitore ha tenuto il suo ritmo. Noi però siamo arrivati puntuali, perché avevamo pianificato sui suoi numeri e non sulle sue dichiarazioni.

Successivamente ho condiviso con lui, in modo trasparente, cosa avevamo misurato e cosa avevamo fatto. E lui ha cambiato approccio.

Conclusione

Quindi no, non è vero che non posso farci niente. Come minimo posso misurare, e sapere cosa posso promettere a mia volta. Poi posso giocare d’anticipo, sperimentare il pressing e vedere se cambia qualcosa. E posso portare i dati al fornitore, perché il suo sistema può migliorarlo solo lui.

Chi ha già un sistema Kanban strutturato può fare il passo successivo con le classi di dipendenza, di cui ho scritto nell’articolo Come funziona Kanban: gestire le dipendenze esterne con le classi di dipendenza.

Bibliografia

  1. David J. Anderson, Teodora Bozheva, Kanban Maturity Model: A Map to Organizational Agility, Resilience, and Reinvention – 2nd Edition, Kanban University Press, 2021

Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti.
Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.

L’intelligenza artificiale accelera il lavoro, ma il Lead Time è fatto per lo più di attese

Quando mi chiedono che lavoro faccio, e chi me lo chiede non ha chiaro perché serva un consulente per migliorare i flussi di lavoro, parto sempre dall’efficienza di flusso.

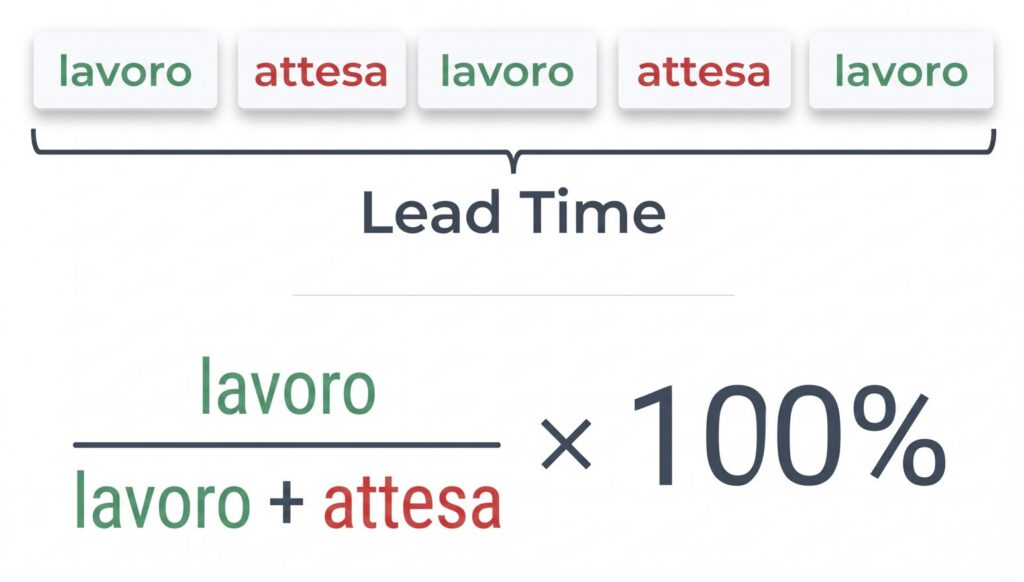
L’efficienza di flusso è il rapporto tra il tempo in cui si lavora effettivamente a un’attività e il tempo totale che passa dall’inizio alla fine di quella stessa attività, cioè il Lead Time. Nella pratica, di solito non si usa come indicatore operativo, perché non è semplice da calcolare. Si usano le pratiche del metodo Kanban, le quali, come risultato, aumentano l’efficienza di flusso. Comprenderne la dinamica, pur senza calcolarla, permette comunque di afferrare il senso del metodo Kanban.

Quando l’efficienza di flusso è bassa, cioè sotto il 15% secondo il Kanban Maturity Model (KMM), il margine di miglioramento sta soprattutto nell’eliminare i tempi di attesa. Il che si ottiene limitando il lavoro in corso, riducendo code e buffer e gestendo meglio problemi bloccanti e dipendenze, tutte pratiche Kanban. Anderson ne ha parlato in un recente keynote, che ho sintetizzato in un articolo. Qui voglio riprendere e approfondire questo specifico aspetto.

Il lavoro effettivo è inizialmente solo una piccola parte del tempo

Il Toyota Production System, precursore del metodo Kanban, ha messo al centro proprio questo: non far andare più veloci gli addetti all’assemblaggio dei veicoli, ma eliminare le attese che stanno intorno al lavoro vero e proprio.

Nel lavoro di concetto, knowledge work in inglese, il ragionamento è identico, con una differenza. La materia prima è l’informazione. Se si parte senza averla tutta e questa arriva un po’ per volta, ci si ferma ad aspettarla, si riparte, ci si ferma di nuovo.

Prendiamo lo sviluppo software. Si comincia a sviluppare e a un certo punto manca un requisito del cliente, perché non era chiaro in fase di analisi. Si chiede al cliente, poi ci si ferma e si aspetta. Quando si ha la risposta, si riprende a lavorare fino a quando si incappa in un altro requisito poco chiaro e ci si ferma di nuovo. E così via. Alla fine il software è pronto, lo si consegna al cliente per il test e si resta in attesa del suo feedback. Se si sommano le attese, nell’esperienza mia e di molti colleghi della community Kanban, queste costituiscono la parte largamente prevalente del Lead Time.

Andare più veloci non è la leva

Per questo, all’inizio di una consulenza, una delle prime cose su cui lavoro è smontare l’idea, diffusa, che l’efficienza si ottenga facendo lavorare più in fretta le persone.

Il punto è controintuitivo. Limitare il lavoro in corso significa che le persone si occupano di meno cose contemporaneamente. Nella mia esperienza questo le porta a ricavarsi il tempo per riflettere su come tagliare i tempi morti, e dopo un po’ il processo va più veloce, senza che nessuno debba affannarsi. Nelle organizzazioni di cui parlo nei miei case study ho visto riduzioni del Lead Time fino al 90%, risultati che sono analoghi a quelli riscontrati da colleghi della community.

Cosa c’entra l’intelligenza artificiale

A più di un lettore può essere venuto a questo punto il dubbio: ma cosa c’entra questo ragionamento con l’intelligenza artificiale? Oggi, nel lavoro di concetto, l’AI viene usata soprattutto per la produttività personale. Aiuta a scrivere un testo, a fare calcoli, a preparare un’analisi, a sviluppare codice, e ognuno di questi compiti si svolge più in fretta.

Ma applicare l’AI a queste attività risponde alla stessa logica del far andare più veloci le persone. Accelera il lavoro effettivo, che è la parte più piccola del Lead Time.

Un esempio numerico: supponiamo che il lavoro effettivo sia il 10% del Lead Time, quindi due giorni su venti, e che l’AI lo dimezzi. Il lavoro passa a un giorno, il Lead Time a diciannove giorni, con un miglioramento del 5%. Il 10% è un’ipotesi esemplificativa, in linea con una situazione sotto la soglia del 15% del KMM, che è l’ordine di grandezza da cui partono i casi che seguo. Il dimezzamento del lavoro effettivo è generoso, per cui nella realtà il miglioramento è probabilmente inferiore.

A fronte di un miglioramento di questa entità, il costo dell’AI può essere anche rilevante, come riferito nel keynote da Anderson. Tornando all’esempio del software: se l’AI fa scrivere il codice più in fretta, il collo di bottiglia resta la risposta del cliente, e il problema non è risolto.

Serve un uso sistemico dell’intelligenza artificiale

La domanda giusta è come si potrebbe usare l’AI per ridurre le attese, che sono ciò che incide davvero sul Lead Time. Personalmente, un uso sistemico di questo tipo non l’ho ancora visto.

Se e quando lo troveremo, otterremo più valore dall’investimento. Anche questo ragionamento conferma però un tema che ho già sollevato in miei articoli precedenti: serve qualcuno che pensi a come gestire il sistema di lavoro e gli strumenti, l’AI compresa. Questo compito non viene eliminato dall’intelligenza artificiale, e continua a essere necessario come lo è sempre stato.

Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti.
Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.