Una frase che mi capita spesso di sentire è più o meno questa: “Noi potremmo organizzarci meglio e rendere prevedibile il nostro lavoro, ma i tempi di certe operazioni dipendono dagli altri. Non possiamo farci niente.”
Ogni volta che l’ho sentita ho pensato che avrei dovuto scrivere questo articolo. Perché non è vero che non ci si può fare niente: si può fare qualcosa, e anche di abbastanza semplice.
Chiamo fornitore chiunque debba fare qualcosa per me senza che io ne abbia il controllo. Può essere un’azienda esterna, ma anche un collega di un’altra funzione.
Prima di tutto, misurare
Se dipendo da qualcuno che ci mette tanto tempo, la prima cosa da capire è cosa vuol dire quel “tanto”. Se il fornitore non mi dà le sue metriche, le prendo io: è quella che chiamo ‘metrica reciproca’. Misuro il tempo che passa da quando faccio la richiesta a quando ricevo la risposta, e lo faccio abbastanza a lungo da costruire una curva di distribuzione del Lead Time.
Non servono migliaia di dati. Se il fenomeno è consistente, cioè se i tempi restano più o meno sempre nello stesso range, siamo in quello che Taleb chiama Mediocristan. Il Kanban Maturity Model (KMM) offre una regola pratica per verificarlo: il rapporto tra il 98° percentile e la mediana deve stare sotto 5,6. In quel caso una trentina di misurazioni bastano per avere un quadro piuttosto affidabile.
Abbastanza spesso, a misure prese, scopro una cosa banale: il fornitore non è imprevedibile, è semplicemente più lento di quanto dichiara. E lo è in modo costante.
Decidere con i dati
Il riferimento abituale è l’85° percentile: sei volte su sette la risposta arriva entro quel tempo. Il KMM definisce il Lead Time proprio così: se so quando mi serve la consegna, il Lead Time è l’anticipo con cui devo fare l’ordine per aspettarmi di riceverla in tempo.
A questo punto confronto quel valore con il tempo di cui ho bisogno. Se la risposta mi serve più in là dell’85° percentile, la richiesta va in classe di servizio standard: la mando con il giusto anticipo e so che, storicamente, arriverà in tempo. È inutile sollecitare, ed è inutile sorprendersi ogni volta dei tempi lunghi. Li conosco.
Se invece mi serve prima, il rischio di andare lunghi è più alto di quello che posso permettermi, e la richiesta va segnalata come urgente. Più il tempo è stretto, più il rischio è alto, e la distribuzione mi dice esattamente quanto. L’urgenza però deve restare un’eccezione: se tutto arriva urgente, il fornitore smette di crederci. Per questo conviene giocare d’anticipo il più possibile.
Provare a pressare e poi misurare di nuovo
“Va bene, ma allora come facciamo?” A questo punto posso fare un esperimento: pressare il fornitore e vedere cosa succede alla distribuzione. Se si comprime e l’85° percentile rientra nel tempo che mi serve, ho trovato un pattern su cui contare: il pressing diventa strutturale e lo faccio di default. Se non si comprime, ho comunque imparato che quella leva non funziona.
In ogni caso devo continuare a misurare, perché il pressing cambia il sistema. E devo tenere a mente che, se i miei tempi si accorciano, forse sto solo passando davanti agli altri clienti del fornitore: io miglioro, il suo sistema no.
Le misure servono anche a valle. Se a mia volta devo garantire dei tempi a un cliente, interno o esterno, il mio livello di servizio atteso (SLE – Service Level Expectation) deve tenere conto di quello che so del mio fornitore. È inutile promettere cose che so già di non poter mantenere a causa di qualcun altro.
Un caso reale
Con un fornitore con cui c’è una buona collaborazione dovevamo chiudere un progetto. Il fornitore dichiarava di poter finire entro fine febbraio, e per farcela avrebbe dovuto rilasciare circa nove work item a settimana. Gli abbiamo preso le misure, ricostruendole da progetti passati: ne rilasciava tre, in modo piuttosto stabile.
Non potevamo triplicare il suo Throughput, così abbiamo triplicato il tempo e pianificato la consegna per fine aprile. A lui abbiamo continuato a indicare fine febbraio. Abbiamo misurato il Throughput e non il Lead Time, ma con un sistema stabile vale la Legge di Little e il risultato non cambia: circa tre mesi.
Il progetto si è chiuso, come previsto, a fine aprile. La scadenza più stretta non ha accelerato nulla: il fornitore ha tenuto il suo ritmo. Noi però siamo arrivati puntuali, perché avevamo pianificato sui suoi numeri e non sulle sue dichiarazioni.
Successivamente ho condiviso con lui, in modo trasparente, cosa avevamo misurato e cosa avevamo fatto. E lui ha cambiato approccio.
Conclusione
Quindi no, non è vero che non posso farci niente. Come minimo posso misurare, e sapere cosa posso promettere a mia volta. Poi posso giocare d’anticipo, sperimentare il pressing e vedere se cambia qualcosa. E posso portare i dati al fornitore, perché il suo sistema può migliorarlo solo lui.
David J. Anderson, Teodora Bozheva, Kanban Maturity Model: A Map to Organizational Agility, Resilience, and Reinvention – 2nd Edition, Kanban University Press, 2021
Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti. Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.
Quanto sta spendendo davvero la vostra azienda in intelligenza artificiale, e come fate a sapere se quella spesa sta producendo un miglioramento reale? È la domanda al centro del recente keynote speech di David Anderson tenuto a Norimberga, che è stato riproposto da Anderson stesso in un webinar e che qui riprendiamo e sintetizziamo. Non è un intervento sulla tecnologia AI in sé, ma su un problema molto più vecchio e sempre attuale: come si fa a sapere se un cambiamento produrrà un miglioramento? Da quella domanda è nato, quasi un decennio fa, il framework Fit for Purpose, sviluppato da Anderson insieme ad Alexei Zheglov.
Il problema: aziende che investono senza strategia
Anderson racconta di parlare regolarmente con aziende i cui team, un tempo dedicati all’agile coaching, oggi lavorano su iniziative di intelligenza artificiale. Lo schema che vede ripetersi è molto simile: prima si è provato l’agile in piccola scala senza risultati, poi si è scalato con qualche framework dedicato spendendo molto e rallentando ulteriormente, infine si sono licenziati scrum master e product owner, rinominando i superstiti con titoli come flow manager o transformation coach. Ora quelle stesse persone sono state messe a capo delle iniziative di AI, nella speranza che la tecnologia risolva ciò che l’agile non è riuscito a risolvere. Anderson sottolinea come questa non sia una strategia: è essenzialmente una speranza, unita a una spesa ingente.
Che cosa significa il concetto di satisficing
Il termine, coniato dall’economista e matematico Herbert Simon (premio Nobel per l’economia) a metà degli anni Cinquanta, nasce dalla fusione di “satisfactory” e “sufficient“. Simon studiava i grafi di rete e un problema ben noto nelle organizzazioni industriali: se si chiede a ogni singolo nodo di una rete, per esempio ogni reparto o linea produttiva, di ottimizzare la propria efficienza, i nodi finiscono per competere tra loro e il risultato complessivo diventa inefficiente. Un ottimo locale non produce un ottimo globale.
La soluzione individuata da Simon non era chiedere ai singoli nodi di ottimizzare, ma di raggiungere un livello, appunto, satisficing: sufficiente e soddisfacente. Se ogni nodo persegue quel livello, l’intera rete tende a un ottimo globale a partire da livelli locali di sufficienza. Applicato a un’azienda, questo significa che ogni servizio della rete organizzativa ha bisogno di metriche proprie che definiscano cosa rappresenti, per quel nodo, un livello soddisfacente e sufficiente di performance, per poi usarle in un ciclo di retroazione locale.
Il costo reale dell’AI
Anderson porta alcuni dati per dare la misura del problema. Uber avrebbe budgetato 1.800 dollari al mese per dipendente per l’AI, ma starebbe in realtà spendendo circa 5.400 dollari al mese. Un insider che lavora a un’iniziativa di AI agentica in una nota grande azienda tecnologica americana, riferisce una spesa di circa 4.000 dollari al mese per dipendente. Numeri che, calcolati in relazione a un ingegnere software con stipendio tra 150.000 e 300.000 dollari l’anno, possono sembrare sostenibili, ma che non reggono in altri mercati: a Lisbona, dove ha tenuto lo stesso keynote due mesi prima di Norimberga, una cifra del genere equivarrebbe a raddoppiare il costo del lavoro.
Una ricerca dell’Economist dello scorso giugno indica che l’1% delle aziende globali per capitalizzazione spende in media 7.500 dollari al mese per dipendente, ovvero circa 100.000 dollari l’anno. Il range che emerge da queste fonti è quindi tra 50.000 e 100.000 dollari l’anno per dipendente, a fronte di un miglioramento di produttività atteso di circa quattro volte, ma con pochissime evidenze concrete di benefici di business. Molti di questi budget vengono sottratti ad altre voci, come la formazione, di cui l’AI arriva a costare fino a dieci volte tanto per dipendente.
Agilità aziendale su due livelli
L’agilità enterprise si gioca su due dimensioni: la capacità di far girare più velocemente il business quotidiano (Run the Business), rispondendo a cambiamenti di mercato e di domanda, e la capacità di reinventarsi, di cambiare direzione quando serve (Change the Business). Storicamente gli sponsor aziendali delle iniziative agili si aspettavano velocità, e i coach che negli anni hanno sostenuto che “l’agile non è mai stato sulla velocità” hanno spesso pagato quella loro affermazione con il posto di lavoro.
Pensare per servizi, non per team
Un’organizzazione va modellata come una rete di servizi interdipendenti, non come una gerarchia. Una richiesta cliente attraversa più team per essere evasa: la Kanban board rappresenta il servizio, non la struttura organizzativa. L’unità molecolare dell’agilità aziendale non è mai stata il team, ma il servizio. Per ciascun servizio serve un proprio sistema Kanban e un proprio set di metriche di satisficing, tra cui lead time, prevedibilità, puntualità, qualità funzionale e non funzionale, conformità normativa, convenienza, adattabilità, configurabilità e sostenibilità economica.
Un punto che Anderson sottolinea con un esempio personale: l’AI non prende decisioni, genera opzioni. Con la sua stessa casella di posta come esempio, racconta di ricevere continuamente analisi con più opzioni da valutare, generate rapidamente dai suoi collaboratori grazie all’AI, che finiscono per far perdere tempo prezioso a chi deve poi decidere, lui compreso. È un caso concreto di ottimizzazione locale che crea un problema altrove nella rete, in questo caso al vertice dell’azienda.
Il problema dell’efficienza di flusso
Dati raccolti in vent’anni di lavoro con la community Kanban dicono che in molte organizzazioni solo l’1-2% del lead time complessivo di una richiesta cliente corrisponde a lavoro effettivo, il resto sono code. Se una richiesta impiega 100 giorni per essere evasa ma richiede un solo giorno di lavoro effettivo, applicare l’AI a quel giorno di lavoro, riducendolo per esempio di un fattore quattro, porta il lead time percepito dal cliente a restare sostanzialmente invariato. Il discorso cambia se il servizio ha già un’efficienza di flusso alta, per esempio del 50-60%: in quel caso l’AI può davvero dimezzare il lead time o raddoppiare la produttività. Il rischio più comune, però, è che l’AI ottimizzi localmente una fase già poco significativa nel flusso complessivo, spostando semplicemente il collo di bottiglia altrove nell’organizzazione, senza produrre alcun miglioramento globale percepibile, pur continuando a consumare budget.
Autonomia locale e doppio ciclo di retroazione
Perché il miglioramento locale funzioni, ogni nodo della rete deve poter agire con autonomia, perseguendo il proprio livello di satisficing e non un ottimo assoluto. Anderson descrive due cicli di retroazione (double-loop learning): uno interno, che chiede se il servizio sta rispettando i propri criteri di satisficing, e uno esterno, che chiede se quei criteri sono ancora quelli giusti da misurare. Quando i servizi sono collegati tra loro, ogni servizio dipendente deve conoscere cosa rappresenta un livello soddisfacente per il servizio che lo richiede, in modo che la sufficienza si propaghi lungo tutta la rete fino al cliente finale.
L’ottimizzazione globale parte dai nodi a contatto diretto con il cliente e si propaga verso l’interno dell’organizzazione attraverso pratiche di revisione periodica, documentate nel Kanban Maturity Model. Se il meccanismo funziona, i diversi nodi della rete possono scambiarsi capacità, competenze e priorità: un nodo può accettare di essere sub-ottimale per contribuire a un miglioramento globale, ma questo richiede che i sistemi di incentivo dei manager siano allineati al bene della rete e non alla sola performance locale.
Cosa fare, a prescindere dall’AI
Anderson suggerisce un percorso in tre passi, indipendente dalla tecnologia scelta:
visualizzare, dotare di strumenti di misurazione e gestire il flusso delle richieste cliente end to end, non a livello di singolo team, con il Kanban Maturity Model
definire i criteri di satisficing con il framework Fit for Purpose
implementare un ciclo di retroazione locale che porti quelle metriche al livello desiderato
Solo a queste condizioni ha senso chiedersi se un investimento in AI, applicato a un nodo specifico della rete, produrrà un miglioramento reale e misurabile, con un’analisi di ritorno sull’investimento che tenga conto sia della spesa locale sia dell’impatto globale sul business. E solo se si gestisce il flusso di lavoro per ogni servizio, si potrà sapere se l’AI ha generato dei miglioramenti oppure no.
Il confronto con Kanban su scala enterprise
Il keynote si chiude con un termine di paragone: le implementazioni Kanban su scala enterprise fatte correttamente producono tipicamente un miglioramento di produttività da 4 a 8 volte, una riduzione del 90% dei lead time e del time to market, con un costo inferiore all’1% del costo del lavoro esistente. Adam Woo, coach Kanban di Shenzhen, ha realizzato più di sei implementazioni su scala superiore alle 5.000 persone, la più grande delle quali in Huawei con 100.000 persone coinvolte. Un risultato, osserva Anderson, spesso migliore di quanto ci si aspetti dall’AI, e a una frazione del costo.
Anche nella sua organizzazione, Kanban University, Anderson riconosce all’AI un ruolo utile, per esempio nelle operazioni IT che mantengono il sito e la piattaforma Kanban+. Ma da CEO ammette di non gradire quando l’AI, usata dai suoi collaboratori, finisce per generare più lavoro di revisione per lui: spostare il collo di bottiglia al vertice dell’azienda non è mai una buona strategia.
Il keynote completo, con tutti i dati e gli esempi qui solo sintetizzati, è disponibile integralmente sul canale YouTube di Kanban University: https://youtu.be/ZWfUq8Z9soc.
Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti. Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.
Si parla sempre più di intelligenza artificiale come soluzione definitiva per rivoluzionare i servizi legali. La promessa è seducente: efficienza immediata, risultati straordinari. Ma c’è un rischio concreto che viene sistematicamente ignorato: se l’AI viene applicata in organizzazioni non strutturate, l’efficienza che si ottiene potrebbe essere solo un’illusione.
L’ottimizzazione locale non è efficienza di sistema
L’uso prevalente degli strumenti AI oggi è focalizzato sull’individuo: si accelera la redazione di un contratto, si comprime un’analisi da due ore a venti minuti. Il risultato sembra maggiore produttività. Questo però, dal punto di vista del pensiero sistemico, può significare che si spreca lavoro più velocemente.
Se un professionista all’interno di un flusso di lavoro redige più velocemente un documento ma il collo di bottiglia è la revisione affidata a una sola persona a valle della redazione, il revisore sarà ancora più sopraffatto. Più lavoro in ingresso genera più lavoro in corso, più code, più rilavorazioni. Questo è il rischio classico dell’ottimizzazione locale: si migliora una parte del sistema ma il sistema complessivo potrebbe peggiorare.
Uscire da questa logica richiede un cambiamento di prospettiva radicale: dall’individuo al flusso.
Un percorso sistemico
Il punto di partenza è riconoscere l’identità del team e sviluppare la collaborazione, uscendo dalla mentalità individuale in cui ognuno ottimizza solo il proprio lavoro indipendentemente dagli altri. Il passo successivo è spostare l’attenzione sul flusso: il team impara a coordinare il lavoro tra i professionisti, a farlo fluire invece di accumularlo. Si arriva infine a uno stadio in cui l’organizzazione è allineata attorno a uno scopo condiviso, capace di erogare il servizio in modo coerente con le aspettative del cliente, quello che in Lean si chiama essere fit for purpose.
È qui che l’AI diventa uno strumento potente. Non prima.
Il punto di partenza è stato l’approccio STATIK (Systems Thinking Approach to Implementing Kanban): un’analisi delle criticità esistenti, la definizione dei flussi di lavoro reali, l’identificazione delle fonti di variabilità e di attrito. Non si è partiti da zero: la prima Kanban board è stata ricavata da un foglio di calcolo già in uso, coerentemente con il principio Kanban di “iniziare da quello che si fa oggi”.
Le pratiche Kanban introdotte – visualizzazione del lavoro, politiche esplicite, cadenze di allineamento, metriche di flusso – hanno trasformato progressivamente la gestione dello studio da un sistema basato sulla memoria individuale a un sistema strutturato, visibile, prevedibile.
I risultati sono stati concreti e percepiti con chiarezza da tutti i professionisti coinvolti. La pressione è diminuita, perché il sistema aiuta a distinguere ciò che dipende dall’organizzazione da ciò che viene dall’esterno. La visibilità è aumentata: lo studio ha collegato le capacità dei singoli in un sistema e ha iniziato a navigarlo avendo a disposizione una ‘bussola e una mappa’. Le relazioni con i clienti sono migliorate, perché conoscere lo stato esatto di ogni pratica permette di comunicare con maggiore precisione e autorevolezza. L’inserimento di nuovi professionisti è diventato più fluido, grazie a protocolli chiari che riducono l’ambiguità. Inoltre, dettaglio controintuitivo, la struttura ha prodotto flessibilità, non rigidità: avendo il controllo del sistema, lo studio ha sviluppato metriche a supporto del processo decisionale – dall’accettazione degli incarichi, alla determinazione delle tempistiche di evasione, fino alle scelte di allocazione delle risorse.
La sintesi, nelle parole dei professionisti coinvolti: “non torneremmo indietro”.
L’AI come passo successivo, non come scorciatoia
L’esperienza di ExLege non è un caso isolato: è la dimostrazione pratica di un percorso che vale per qualsiasi organizzazione di servizi professionali. Prima si costruisce il sistema, poi si introduce la tecnologia.
L’AI non crea ordine dove non c’è ma, nel bene e nel male, amplifica ciò che trova. Applicata a un’organizzazione strutturata, può sbloccare valore reale: coordinare flussi complessi, supportare decisioni strategiche, ridurre il lavoro a basso valore cognitivo. Applicata al caos, lo accelera.
Il vero investimento non è nello strumento. È nell’organizzazione che lo sa usare.
Ho pubblicato originariamente questo articolo su LinkedIn il 3 settembre 2026
Nella mia esperienza di consulente, mi sono imbattuto spesso in organizzazioni governate dal cosiddetto “urlometro”. La priorità non è definita dal valore strategico, ma dal volume delle grida o dall’eroismo plateale dell’ultimo minuto. In questi contesti, ruoli critici come la segreteria o il supporto operativo vivono in uno stato di assedio permanente.
Le interruzioni costanti non sono solo un fastidio. Sono una forma di spreco che distrugge la capacità cognitiva e impedisce di entrare in uno stato di flusso. Proteggere il tempo di concentrazione non è un lusso, ma una necessità operativa. Eppure, la risposta istintiva delle organizzazioni di questo tipo è spesso quella di rifugiarsi in soluzioni tecnologiche che finiscono per aggravare il problema anziché risolverlo.
Quando il digitale è troppo: il paradosso dell’eccesso tecnologico
In un caso che ho affrontato di recente, abbiamo dapprima tentato di domare il caos attraverso una bacheca elettronica. Il risultato? Un fallimento totale, dovuto a un eccesso di ottimismo: lo strumento era troppo sofisticato per un ambiente con bassa maturità digitale e alta resistenza al cambiamento. Quando il divario tra la complessità dello strumento e l’utilità percepita è troppo ampio, la tecnologia diventa un ostacolo.
In contesti di forte attrito culturale, il digitale rischia di nascondere il sovraccarico dietro schermate che nessuno apre. In questi casi, la bassa tecnologia non è un limite, ma diventa un’opportunità strategica. È necessario un sistema che renda il lavoro “fisicamente ingombrante” e impossibile da ignorare.
Il sistema delle vaschette portadocumenti: semplicità e sovraccarico visibile
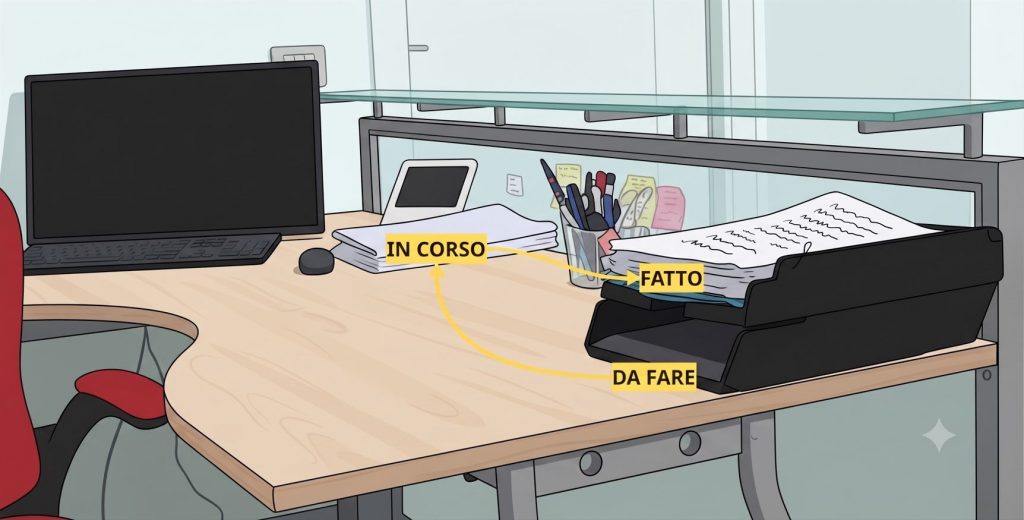
Per superare l’impasse, ho fatto implementare un sistema Kanban radicalmente analogico: due vaschette di plastica e lo spazio fisico della scrivania. A differenza di un software, dove è possibile accumulare centinaia di compiti invisibili senza che nessuno se ne accorga, la fisicità del sistema rende il sovraccarico impossibile da nascondere. Se il lavoro arriva più veloce di quanto se ne riesca a smaltire, non sparisce in un backlog invisibile: si accumula nella vaschetta “Da fare”, che comincia a traboccare. Il blocco del sistema diventa evidente a chiunque passi davanti alla postazione.
Il sistema si basa su tre stati chiari, utilizzando la lingua locale per massimizzare l’adozione e ridurre il carico cognitivo:
Vaschetta “Da fare”: il punto di ingresso unico per le richieste. Rappresenta il backlog fisico.
La scrivania (“In corso”): il perimetro del WIP limit. Se un documento è sulla scrivania, è l’unico su cui si sta lavorando e su cui si può lavorare.
Vaschetta “Fatto”: il deposito del valore completato, pronto per la consegna.
Questo supporto analogico forza visivamente il limite del lavoro in corso. È un meccanismo che rende il sovraccarico tangibile e non occultabile.
La policy della vaschetta: passare dal push al pull
Il cuore del sistema non sono le vaschette, ma la policy comunicativa. È lei a trasformare il flusso da push (interruzioni imposte dall’esterno) a pull (lavoro prelevato in base alla capacità disponibile). La regola è ferrea: “Se hai qualcosa da farmi fare, lasciami un foglio nella vaschetta”.
Abbiamo posizionato una risma di fogli accanto alla vaschetta come dispositivo a prova di errore. L’atto di dover scrivere la richiesta aggiunge un attrito intenzionale che funge da filtro. Se una richiesta non vale il tempo di essere scritta, probabilmente non valeva nemmeno l’interruzione.
Come consulente, insisto sulla logica del one-piece flow, fare una sola cosa alla volta. Quando si libera la capacità si pesca dalla vaschetta ‘da fare’. Si fa una cosa per volta, nell’ordine in cui è arrivata.
Questo buffer permette all’operatore di gestire le interruzioni interne (decidere quando iniziare un nuovo compito), invece di subire le interruzioni esterne (le richieste continue dei colleghi). Protegge così la qualità e la velocità di esecuzione.
Visualizzazione contro ansia: la bacheca informativa passiva
Il micro-management è spesso alimentato dall’ansia del “a che punto siamo?” Le interruzioni per chiedere aggiornamenti sono sprechi che generano altri sprechi. Il sistema a vaschette funge da bacheca informativa passiva: fornisce uno stato dell’arte asincrono senza richiedere interazione umana.
Il responsabile o il collega non ha più bisogno di chiedere. Gli basta osservare:
Il foglio è nella vaschetta “Da fare”? La richiesta è in coda.
Il foglio è sulla scrivania? La lavorazione è in corso in questo istante.
Il foglio è nella vaschetta “Fatto”? Il compito è terminato.
Questa trasparenza agisce come un sedativo per l’ansia da controllo. Elimina il bisogno di domande continue e risparmia all’operatore l’onere emotivo di dover difendere il proprio progresso.
Il triage delle urgenze: verifica delle priorità e il costo dell’attesa
Se tutto è urgente, nulla lo è. Per gestire le eccezioni senza far collassare l’ordine di arrivo, abbiamo introdotto l’uso di post-it rossi. Tuttavia, l’applicazione di un post-it rosso non è un diritto, ma il risultato di una verifica puntuale della priorità.
La domanda strategica da porre a chiunque voglia “saltare la fila” è: “cosa costa aspettare?”. Se il richiedente non sa quantificare il costo dell’attesa, la priorità viene negata. Se il costo è reale, il post-it rosso permette al compito di diventare il prossimo elemento prelevato non appena la capacità si libera. Questo meccanismo di triage protegge l’integrità del flusso per tutto il resto del lavoro.
Conclusione: la fine degli alibi
Il sistema delle vaschette portadocumenti è uno specchio onesto dell’efficienza aziendale. Funziona perché riduce la complessità e rende visibile il valore. Tuttavia, è bene essere chiari: se chi ha l’autorità per farlo, decide deliberatamente di ignorare le policy e continuare a scavalcare i processi con l’autorità, il sistema non reggerà.
Ma c’è un risultato fondamentale che si otterrà comunque: con un sistema del genere, gli alibi finiscono. Se il responsabile scardina le regole, non può più lamentarsi della disorganizzazione o dell’inefficienza dei suoi collaboratori. La responsabilità del caos torna nelle mani di chi lo genera.
Siamo pronti a perseguire una trasparenza che non lascia più spazio a scuse?
Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti. Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.
Nel settore dei servizi molte organizzazioni faticano perché approcciano la leadership con una mentalità meccanicistica. In questo approccio, il leader agisce come un installatore di software: implementa strumenti, “installa” procedure standard e si aspetta che l’azienda funzioni come un ingranaggio perfetto. Per avvicinarsi davvero all’eccellenza nei servizi, però, serve un cambio di prospettiva: il passaggio dalla visione del leader-meccanico a quella del leader-giardiniere. In un’azienda di servizi, dove il valore è creato nell’interazione umana, non si può “installare” l’efficienza, bisogna coltivare le condizioni perché essa possa emergere.
Questo approccio distingue la mera implementazione di strumenti (spesso utile solo nel breve periodo) dalla creazione di una cultura profonda basata sui due pilastri del pensiero Toyota: miglioramento continuo e rispetto per le persone. Per far crescere un’organizzazione sana e resiliente, occorre smettere di agire sulla superficie delle procedure e iniziare a nutrire le radici filosofiche del sistema.
Le radici della crescita: filosofia e pensiero a lungo termine
La filosofia è il substrato nutritivo del modello del giardiniere. Il pensiero sistemico orientato al lungo periodo non è un lusso, ma una condizione per non farsi guidare solo dalla logica del profitto trimestrale. Il modello 4P codificato da Jeffrey Liker identifica infatti la Filosofia (Philosophy) come la base dell’intera struttura:
Philosophy (Filosofia): la base del sistema. Decisioni guidate da uno scopo superiore e dal contributo alla società, anche a scapito dei risultati finanziari immediati.
Process (Processo): il terreno in cui il valore fluisce senza interruzioni.
People (Persone): lo sviluppo del talento attraverso la sfida costante.
Problem Solving (Risoluzione dei Problemi): la disciplina dell’apprendimento organizzativo.
Questo orientamento nasce dalla visione di Sakichi Toyoda, il quale ha insegnato che un leader deve “sporcarsi le mani” e conoscere il business dalle fondamenta. Il suo contributo più noto è il concetto di Jidoka: l’automazione dal tocco umano. Come un giardiniere che progetta un sistema di irrigazione che si arresta se rileva un’anomalia, Sakichi inventò un telaio capace di fermarsi istantaneamente alla rottura di un filo, impedendo la produzione di scarti. Il leader-giardiniere è il custode di questa qualità integrata, attento a non sacrificarla per un risultato immediato.
Vale la pena notare che il modello 4P non è la lettura di un osservatore esterno. Liker racconta di un incontro con il nipote di Sakichi, Eiji Toyoda, l’uomo che ha portato l’azienda da essere un piccolo produttore locale a diventare un colosso globale: sulla sua scrivania teneva copie del suo libro in inglese e in giapponese, e gli disse di aver strutturato il pensiero dell’azienda meglio di quanto Toyota stessa sapesse spiegarlo ai propri dirigenti. Un riconoscimento che pesa, perché arriva da chi il metodo lo ha vissuto dall’interno, non da chi lo ha solo studiato.
Preparare il terreno: ottimizzare il processo per il valore
Prima di piantare qualsiasi cosa, il terreno va preparato, e questo significa affrontare tre tipi di spreco, in un ordine preciso. Il primo è il Muri, il sovraccarico: un terreno a cui si chiede di sostenere più piante di quante ne possa nutrire non produce di più, produce piante deboli su tutta la superficie. Nei servizi è lo stesso: caricare le persone oltre la loro capacità reale non aumenta l’output, lo degrada ovunque. Per questo il Muri va affrontato per primo: chiedere di più a chi è già sovraccarico non lascia energia per occuparsi d’altro.
Il secondo è il Mura, l’irregolarità del flusso: un terreno che riceve troppa acqua oggi e niente per settimane, non fa crescere le piante meglio di uno irrigato con costanza. Sovraccarica in un momento, lascia a secco nell’altro, e il risultato è comunque una qualità compromessa. L’ideale del One-Piece flow (fare una cosa per volta) e della produzione livellata serve proprio a questo: sostituire l’alluvione con un’irrigazione regolare.
Il terzo è il Muda, lo spreco puro: le erbacce che non nutrono nulla e sottraggono solo risorse al resto del giardino. Il Value-Stream Mapping serve a mappare il flusso del valore e riconoscerle per toglierle di mezzo; il lavoro standardizzato è il “palo” a cui si lega la pianta perché cresca nella direzione corretta invece che a caso.
Affrontare gli sprechi in quest’ordine, prima le persone, poi il flusso, poi le attività, permette al giardino di dare il meglio di sé, invece di restare travolto dal caos operativo.
Coltivare il talento: le persone al centro del giardino
Per Toyota, il rispetto per le persone non è mera cortesia; è la responsabilità di sfidare i collaboratori a dare il meglio di sé. Il leader-giardiniere agisce come un coach attraverso l’On-the-Job Development (OJD). Latondra Newton, che ha trasformato il concetto di On-the-Job Development in Toyota da una pratica tacita a un approccio deliberato di coaching e insegnamento, sottolinea un punto cruciale: il coach deve permettere ai membri del team di “oscillare verso i limiti esterni” del sentiero tracciato. Un leader meccanicistico corregge l’errore istantaneamente; un giardiniere permette alla pianta di inclinarsi leggermente per creare un momento di insegnamento, aiutandola a trovare autonomamente la “luce” del miglioramento.
Le 4 fasi del modello OJD sono:
Scegliere un problema con il team: identificare sfide che superino leggermente le capacità attuali.
Dividere il lavoro e rendere la direzione avvincente: assegnare obiettivi che diano senso al lavoro quotidiano.
Eseguire, monitorare e istruire: lasciare spazio alla sperimentazione, intervenendo come guida quando si raggiungono i limiti del processo.
Feedback, riconoscimento e riflessione: consolidare l’apprendimento attraverso il ciclo PDCA.
Il contrario di questo modello è la crescita per vegetazione spontanea: responsabilità che si allargano più in fretta delle competenze, senza che nessuno insegni a chi le riceve gli strumenti di base, leggere un numero, strutturare un obiettivo, gestire una criticità senza improvvisare. Non è un problema di talento, è un’assenza di metodo, spesso scambiata per autonomia quando in realtà è abbandono.
Lo sviluppo del leader avviene attraverso tre ondate progressive, mirate a creare non solo esecutori, ma coach:
Aware (Consapevole): comprendere la teoria.
Able to Do (Capace di fare): applicare i principi nel Gemba.
Able to Teach (Capace di insegnare): sviluppare altri leader. Non esistono scorciatoie: generare nuovi giardinieri è ciò che distingue una leadership che dura da una che si esaurisce con la singola persona.
L’obiettivo del percorso non si esaurisce nella terza ondata individuale. Un leader che diventa Able to Teach comincia a sua volta a coltivare altri all’interno dell’organizzazione: è il punto in cui il modello collettivo di Toyota, il miglioramento che arriva dal basso e si moltiplica, prende forma concreta. Non un solo giardiniere che coltiva un giardino, ma un giardiniere che forma altri giardinieri.
Potatura e cura: il Problem Solving come disciplina di apprendimento
Il Problem Solving è l’arte della “potatura”: eliminare ciò che ostacola la crescita per orientare l’organizzazione verso il True North (il Nord Ideale). Non è una reazione alle emergenze, ma una mentalità scientifica. Il leader-giardiniere pratica il Genchi Genbutsu: va a controllare personalmente lo stato delle “foglie” (i fatti) per individuare i parassiti (le cause radice), rifiutando di affidarsi a report astratti.
Il set di strumenti è il Toyota Business Practices (TBP) strutturato in 8 passi (PDCA):
Plan: 1. Chiarire il problema rispetto all’ideale; 2. Scomporre il problema; 3. Definire target sfidanti; 4. Analisi dei “5 Perché”; 5. Sviluppare contromisure (ipotesi).
Do: 6. Attuare le contromisure con rapidità.
Check: 7. Monitorare sia i risultati che il processo.
Act: 8. Standardizzare i successi e condividere la conoscenza.
Il raccolto: eccellenza nei servizi e impatto sul cliente
L’eccellenza nei servizi non è un obiettivo a sé, è la conseguenza naturale di una leadership che coltiva sistematicamente persone e processi. La differenza tra chi si ferma alla gentilezza superficiale e chi coltiva davvero il sistema si vede proprio dove il cliente la sente di più: nel tempo che deve aspettare, nella fatica che deve fare per ottenere quello che gli serve, nella sensazione di trovarsi dentro un sistema che scorre o dentro uno che arranca nonostante le buone intenzioni di chi lo gestisce.
Un’organizzazione può essere accogliente nei modi e comunque lenta nei fatti, se nessuno ha mai lavorato sul flusso che sta dietro la cortesia. Quando invece il flusso è stato coltivato con cura, la produttività cresce senza che le persone debbano lavorare più in fretta o sotto pressione: cresce perché il lavoro è organizzato meglio, non perché costa più fatica a chi lo fa. Ed è un vantaggio che si misura, non solo si racconta: le organizzazioni che coltivano sistematicamente persone e processi ottengono risultati economici superiori alla media. L’eccellenza, in altre parole, non è un costo aggiuntivo. È un investimento che si ripaga.
Dai concetti alla pratica: un caso concreto
C’è un caso che mi ha riguardato direttamente e che mostra questo intero approccio all’opera, non come principio astratto ma come cosa accaduta nei fatti. Il punto di partenza era tipico: una figura direttiva che stava assumendo responsabilità sempre più ampie con la necessità di apprendere nuovi strumenti di management.
L’ho affiancata con incontri regolari, ogni due settimane, di due o quattro ore. In quel percorso abbiamo costruito insieme, un problema alla volta, l’impianto di governance e la gestione dei flussi di lavoro della struttura che stava nascendo, sempre con la stessa logica: non teoria calata dall’alto, ma gestione dei problemi reali che quella persona portava al tavolo. Ogni incontro affrontava un tema gestionale concreto, come leggere i numeri, come monitorare l’avanzamento del lavoro, come strutturare obiettivi e responsabilità, come gestire le criticità senza improvvisare, partendo sempre da strumenti operativi, una board, delle metriche, un foglio di calcolo, e dalle situazioni reali. Lei si portava a casa qualcosa da applicare da subito, con l’impegno di riportare un riscontro all’incontro successivo.
Nel tempo, quella persona ha cominciato a fare lo stesso con il proprio team: oggi accompagna direttamente i propri riporti con lo stesso approccio che ha vissuto in prima persona. È la cascata che il modello descrive: il giardiniere ha formato un secondo giardiniere, e quel secondo giardiniere ha già cominciato a coltivare il proprio giardino.
Il passo che resta da fare, ed è oggi la proposta sul tavolo, è estendere lo stesso accompagnamento a un gruppo più ampio di figure nella stessa organizzazione, perché la capacità gestionale cresca in modo più ampio e strutturato, invece di restare affidata a singoli rapporti di coaching isolati.
Conclusione: iniziare la trasformazione oggi
La leadership del giardiniere richiede onestà verso se stessi. Se un’organizzazione si limita a risolvere emergenze senza far crescere le persone, sta solo rimandando un problema che si ripresenterà, più grande. La trasformazione inizia quando il leader smette di dare ordini e inizia a porre domande scientifiche al Gemba.
Vale la pena, a questo punto, fermarsi un momento e guardare al proprio stile di leadership con onestà. Quanto tempo si dedica davvero a comunicare uno scopo che vada oltre il risultato del trimestre, e quanto le decisioni prese ogni giorno lo contraddicono nei fatti? Si sta lasciando alle persone lo spazio per sbagliare quel tanto che serve a imparare, o si interviene troppo presto, soffocando con un controllo che finisce per bloccare la crescita? E quante ore, ogni settimana, si passano davvero a osservare il lavoro reale e a fare coaching sul campo, invece che dentro riunioni e report che raccontano il lavoro senza mostrarlo?
Bibliografia
Jeffrey K. Liker, Karyn Ross, The Toyota Way to Service Excellence: Lean Transformation in Service Organizations, McGraw Hill, 2017
Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti. Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.
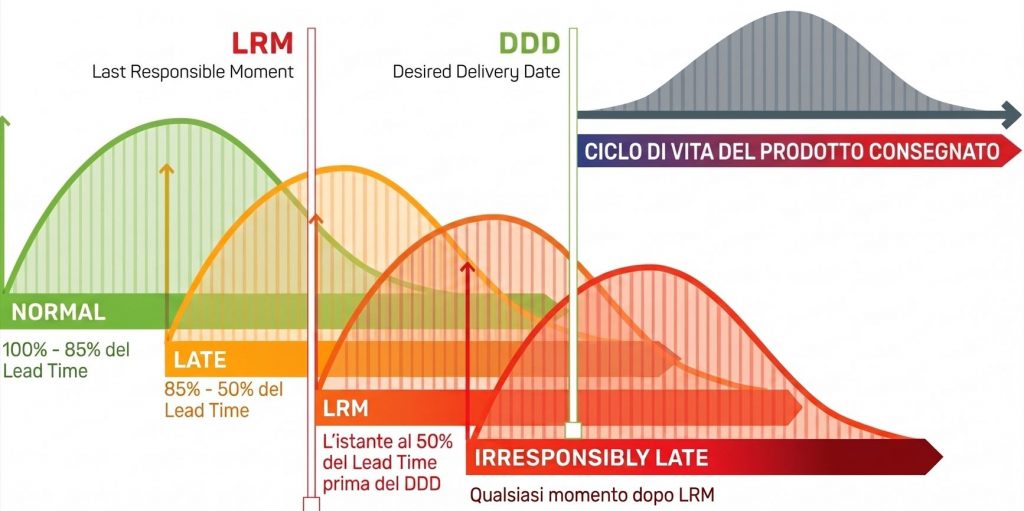
Nel panorama della gestione organizzativa moderna, l’ossessione per la velocità ha spesso oscurato la qualità del processo decisionale. Tuttavia, nel quadro del Kanban Maturity Model (KMM), la vera agilità non risiede nel decidere il più velocemente possibile, ma nel decidere al momento giusto. Il concetto di Last Responsible Moment (LRM) emerge non come una forma di procrastinazione, ma come una scelta strategica di gestione del rischio economico.
In un contesto caratterizzato da incertezza e complessità, decidere troppo presto è un errore pari a quello di decidere troppo tardi: impegna risorse preziose su basi informative incomplete, precludendo la possibilità di adattarsi a nuovi dati. L’LRM invece rappresenta il punto immediatamente precedente alla perdita di fattibilità di un’opzione. Comprendere l’LRM è il primo passo per evolvere da una cultura dell’urgenza reattiva a una gestione proattiva del flusso, dove il tempo è una variabile economica controllata e non un nemico da rincorrere.
La logica del differimento: perché “aspettare” è un vantaggio competitivo
Il differimento dell’impegno (deferred commitment) è una delle pratiche più controintuitive dell’enterprise agility. Permettere a un elemento di lavoro di rimanere nello stato di opzione il più a lungo possibile riduce drasticamente l’impatto della failure demand, ovvero il lavoro abortito e i rifacimenti (rework). Da un punto di vista del senior management, differire l’impegno significa mantenere maggiore liquidità del sistema – capacità produttiva non ancora congelata in scommesse premature, e quindi disponibile per essere allocata quando le informazioni sono più complete.
I tre benefici strategici del differimento dell’impegno sono:
Acquisizione di conoscenza: più a lungo si attende, più informazioni si raccolgono su mercato, tecnologie ed esigenze reali dei clienti.
Riduzione dell’incertezza: il tempo permette di dissipare l’incertezza decisionale, trasformando intuizioni rischiose in decisioni basate su evidenze.
Aumento del tasso di scarto delle opzioni non valide: un sistema che differisce l’impegno seleziona solo le opzioni che sopravvivono all’evoluzione del contesto, eliminando lo spreco alla radice.
Fonte Kanban University – dettaglio del poster Triage Tables
Anatomia matematica del Last Responsible Moment e del rischio temporale
L’LRM non è un’intuizione soggettiva, ma un calcolo basato sulla distribuzione statistica dei tempi di completamento (Lead Time). In un sistema evoluto, la determinazione del momento in cui iniziare un lavoro dipende dalla data di consegna desiderata (Desired Delivery Date – DDD) e dalla probabilità di completamento entro quella data.
Operativamente, l’LRM è definito come il 50° percentile del Lead Time calcolato a ritroso rispetto alla DDD. Iniziare un lavoro esattamente al LRM significa che, in base alla distribuzione storica dei tempi di consegna (Lead Time), c’è solo una possibilità su due (50%) di consegnare entro la data desiderata (DDD). Per le organizzazioni a ML2/ML3, questo rappresenta il punto di equilibrio tra rischio di consegna tardiva e costo del ritardo.
Concetto
Definizione operativa
Implicazione economica
Last Responsible Moment
Decisione consapevole basata sul 50° percentile della distribuzione del Lead Time.
Rischio gestito: equilibrio tra informazione acquisita, Cost of Delay e probabilità di consegna puntuale.
Irresponsibly Late
Decisione presa oltre la finestra di confidenza statistica.
Scommessa probabilistica: l’organizzazione subisce le conseguenze di un eventuale fallimento invece di gestire il rischio.
Un pilastro tecnico fondamentale è l’Urgenza, definita come la derivata (pendenza) della funzione Probable Cost of Delay in Starting (PCoDS). Senza entrare in tecnicismi matematici, la PCoDS è una curva che indica il rischio economico immediato derivante dal non iniziare un lavoro in una data specifica.
Il Last Responsible Moment e la disciplina del triage: ora, dopo, mai
L’integrazione dell’LRM trasforma il Replenishment Meeting in un processo di triage rigoroso. Basandoci sulla valutazione delle opzioni reali, comprendiamo che queste hanno valore e hanno una scadenza; pertanto, non si deve mai decidere in anticipo senza un motivo esplicito.
Il triage categorizza il lavoro in tre direzioni:
Ora: elementi che hanno raggiunto il proprio LRM e devono essere messi in lavorazione per onorare la promessa di consegna.
Dopo: opzioni che non hanno ancora raggiunto l’LRM e restano in attesa perché si possa acquisire ulteriore conoscenza relativa alla loro lavorazione.
Mai: opzioni scartate perché superate da nuove informazioni.
Questa logica di triage è applicabile esclusivamente a opzioni per le quali i dati storici sono significativi. Se il valore dell’opzione è incerto o imprevedibile l’LRM perde di efficacia e l’elemento deve essere gestito tramite allocazione di capacità dedicata come classe Intangible.
Il compromesso strategico: Classi di Servizio e Costo del Ritardo
Differire l’impegno fino all’LRM comporta un trade-off. Se si attende troppo vicino al limite, il sistema viene caricato di rischi temporali che possono richiedere classi di servizio costose per garantire la consegna.
Le quattro classi di servizio canoniche riflettono la sensibilità al tempo e alla PCoDS:
Expedite: per elementi con urgenza critica e pendenza della PCoDS altissima. Richiedono un intervento immediato, spesso violando i limiti al lavoro in corso (WIP).
Fixed Date: elementi con data di consegna fissa e costo elevato per il superamento della scadenza. Richiedono impegno vicino all’LRM con priorità di pianificazione alta.
Standard: il cuore del sistema, gestito solitamente tramite logica FIFO (First-In, First-Out) per garantire massima prevedibilità e stabilità del Lead Time.
Intangible: elementi con basso costo del ritardo immediato ma alto valore a lungo termine. Fungono da protezione rispetto al rischio strategico: la loro presenza nel sistema crea lo spazio necessario per assorbire le richieste Expedite senza destabilizzare il flusso.
Evoluzione organizzativa: dal caos alla resilienza
La padronanza dell’LRM evolve man mano che le organizzazioni si strutturano:
ML2 (Customer Awareness): le decisioni sono spesso emotive o reattive. Il Flow Manager inizia a raccogliere dati, ma la mancanza di stabilità rende il calcolo dell’LRM ancora approssimativo.
ML3 (Fit-for-Purpose): emergono i ruoli chiave. Il Service Request Manager (SRM) diventa il custode delle opzioni e dell’LRM, mentre il Service Delivery Manager (SDM) garantisce la stabilità della capacità del sistema. Il triage diventa sistematico.
ML4 (Risk-Hedged): l’LRM non è più una stima generale al 50° percentile, ma un calcolo specifico per ogni elemento di lavoro ad alto valore, basato su simulazioni Monte Carlo e profili PCoDS personalizzati.
Conclusione: il Last Responsible Moment come pilastro della prosperità aziendale
Il Last Responsible Moment non è un tecnicismo, ma il fondamento della resilienza strategica. La sua applicazione sposta l’attenzione dalla mera efficienza delle risorse (tenere le persone occupate) alla efficienza di flusso e alla resilienza economica.
Il traguardo finale di questa disciplina è l’allineamento tra identità aziendale, strategia (perché/cosa) e decisioni operative quotidiane (come/chi). Quando un’organizzazione sa perché decide e quando è il momento di farlo, smette di subire il mercato e inizia a guidarlo.
La leadership dell’organizzazione deve investire nella raccolta rigorosa dei dati sui Lead Time e nella modellizzazione dei costi del ritardo. Solo trasformando l’LRM da concetto astratto a strumento guidato dai dati, l’organizzazione potrà prosperare a lungo termine in un mondo volatile.
Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti. Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.
Un’altra domanda che mi è stata fatta durante la presentazione del mio libro riguardava i Cicli di Feedback, che nel libro descrivo come vera catena di trazione di un sistema Kanban. Vale la pena approfondire questo tema e nel farlo affidarsi a una analisi fatta da Andreas Bartel, che ha dato un significativo contributo alla definizione e rappresentazione delle cadenze Kanban così come le conosciamo oggi nel Kanban Maturity Model (KMM). Ho tratto i concetti di questo articolo da un intervista fatta allo stesso Bartel nel 2023, ho indicato il link al video originale nelle Fonti.
Immaginate di fare trekking tra le vette delle Alpi. Per raggiungere la meta in un ambiente così dinamico, non basta la forza muscolare; serve un dialogo costante tra voi, la mappa e la bussola. Questo rapporto è un sistema chiuso di retroazione: la bussola fornisce una direzione, voi agite camminando e il mutamento della vostra posizione offre nuovi dati allo strumento. Nel management moderno, questo fenomeno prende il nome di Ciclo di Feedback. Sebbene le aziende ne siano immerse, questi cicli sono spesso invisibili o, peggio, ignorati. Eppure, comprendere la meccanica dei cicli di feedback non è un mero esercizio accademico: è l’essenza stessa della navigazione in condizioni di incertezza, il confine sottile tra un’organizzazione che evolve e una che declina senza nemmeno rendersene conto.
I Cicli di Feedback sono fenomeni naturali, non invenzioni umane
Un ciclo di feedback è una relazione bidirezionale intrinseca: l’output di una parte diventa l’input dell’altra, creando una circolarità continua. È fondamentale liberarsi dell’idea che i cicli di feedback siano “processi burocratici” o semplici riunioni istituite dal management. Essi esistono in natura – regolano il clima e le popolazioni animali – e proliferano spontaneamente in ogni azienda sotto forma di network organizzativi informali o sistemi di retroazione ombra. Le conversazioni non strutturate davanti alla macchinetta del caffè sono cicli di feedback tanto quanto i report finanziari.
I cicli di feedback sono agnostici rispetto a qualsiasi cosa l’uomo possa inventare o introdurre in un’organizzazione, perché esistono comunque. Riconoscere questa natura spontanea e non governabile dei feedback è il primo passo per smettere di subirli e iniziare a gestirli consapevolmente.
La polarità del successo: perché il feedback negativo può salvarci
In teoria dei sistemi, i cicli di feedback non sono tutti uguali; possiedono polarità distinte che determinano il comportamento dell’organizzazione:
Ciclo di Feedback positivo (rinforzante): amplifica la direzione attuale. Pensate all’interesse composto: più capitale genera più interessi, che aumentano il capitale. È il motore della crescita, ma se non regolato, può condurre all’esplosione o al collasso del sistema.
Ciclo di Feedback negativo (bilanciante): funziona come un meccanismo di stabilizzazione. In natura, è il rapporto preda-predatore (ghepardo-gazzella): l’aumento dei predatori riduce le prede, il che alla fine riduce i predatori, riportando il sistema in equilibrio.
L’intuizione paradossale per un leader è che, mentre il business insegue ossessivamente il “positivo”, è la capacità di innescare cicli negativi a garantire la stabilità e la sopravvivenza a lungo termine, impedendo al sistema di andare fuori giri.
L’errore fatale di Kodak e la metafora delle neuroscienze
Perché aziende leader falliscono nonostante vedano arrivare il cambiamento? Bartel introduce una potente analogia tratta dalle neuroscienze. Un ciclo di feedback interrotto (broken feedback loop) agisce come una patologia delle aree motorie: il cervello percepisce l’ambiente, ma il circuito neurale verso i muscoli è danneggiato. L’individuo vuole afferrare un oggetto, ma non riesce a coordinare il movimento.
Il caso Kodak è l’esempio clinico di un’organizzazione con i “circuiti motori” distrutti. L’azienda aveva percepito il segnale della fotografia digitale, ma non è riuscita a tradurre il segnale in azione, continuando a rinforzare gli investimenti nelle vecchie competenze analogiche. Il fattore critico, però, non è tecnico: è umano. I decisori possono percepire chiaramente i segnali del mercato e tuttavia scegliere di non agire, o di agire nella direzione sbagliata. L’inerzia non è ignoranza: è spesso il risultato di pressioni politiche interne, di identità aziendali consolidate, di incentivi che premiano la continuità piuttosto che il cambiamento. In Kodak, il circuito percettivo funzionava; era il passaggio dal segnale all’azione ad essere bloccato da decenni di successo.
La vera agilità è la gestione della polarità
Per un esperto di business agility, un’organizzazione eccellente non è quella che cresce linearmente, ma quella capace di cambiare polarità in modo fluido.
La vera agilità consiste nella capacità sistemica di accendere o spegnere i cicli positivi e negativi. Se il mercato cambia, bisogna avere il coraggio di attivare un ciclo negativo per “smorzare” e disinvestire in settori storici, liberando capacità per costruire nuove competenze. Molte aziende restano vittime di un ciclo negativo disfunzionale che protegge lo status quo: ogni tentativo di cambiamento viene “rimbalzato” dal sistema, che torna pigramente al punto di partenza. L’agilità è, in ultima analisi, il potere di decidere quale ciclo alimentare e quale interrompere, prima che sia il sistema a decidere per noi.
Riunioni vs. Cadenze: riprendere il controllo del sistema
È vitale distinguere il ciclo di feedback (il fenomeno naturale) dalla Cadenza (lo strumento di controllo). Se i cicli di feedback avvengono ovunque, la cadenza è il ritmo regolare che rende questi cicli espliciti e governabili. In ambito Kanban, abbiamo otto cadenze, delle quali tre essenziali:
Replenishment Meeting: il momento della selezione strategica. Si decide cosa iniziare, prendendo in carico il lavoro in base alle reali priorità degli stakeholder.
Kanban Meeting: una cadenza operativa che agisce come regolatore del flusso di lavoro. Non è un semplice aggiornamento, ma una prospettiva operativa per gestire la pipeline e assicurare la fluidità della consegna.
Service Delivery / Flow Review: un momento di riflessione profonda sulla qualità e l’efficacia del sistema. La frequenza di questa cadenza dipende dal livello di maturità dell’organizzazione e dalla velocità con cui il sistema necessita di apprendere dai propri errori.
Una questione di adattamento evolutivo
La storia economica dimostra che il successo non è legato alla forza, ma alla qualità dei cicli di feedback. Le organizzazioni che prosperano sono quelle che hanno trasformato il feedback in un meccanismo evolutivo: percepiscono il cambiamento, regolano i meccanismi interni e rispondono con senso. Non è solo efficienza, è adattamento biologico applicato al business.
Il contraltare di Kodak esiste, ed è istruttivo proprio perché non racconta una trasformazione semplice. Fujifilm percepì lo stesso identico segnale – la fotografia digitale avrebbe reso obsoleta la pellicola – e scelse di cambiare polarità. Non abbandonò il passato, ma lo usò come piattaforma: le competenze in chimica delle emulsioni fotografiche vennero reindirizzate verso cosmetici, materiali ottici e farmaceutica. Fujifilm non sopravvisse nonostante i suoi successi; li usò come punto di partenza per diventare qualcos’altro.
La tua organizzazione ha il coraggio di cambiare polarità e andare oltre i successi del passato, o sta aspettando che sia il mercato a scegliere per lei?
Durante la presentazione del mio libro, mi è stato chiesto: Come si porta un team dal “non è colpa mia” al “me ne faccio carico”?
È una domanda che mi sono posto anche nel 2010. Avevo un gruppo di persone capaci, ma bloccate. Il mercato era difficile, le risorse scarse, e in quelle condizioni è facile scivolare nella narrativa della vittima: il sistema non funziona, i piani alti non capiscono, il budget non c’è. Non era pigrizia. Era qualcosa di più sottile: una progressiva abdicazione della responsabilità, fatta di piccoli passi, quasi invisibile.
In quel periodo seguivo Mourinho – lo seguivo da prima che arrivasse all’Inter, perché avevo visto e letto qualcosa di suo e, a prescindere da certi suoi atteggiamenti e dal tifo calcistico, mi ero accorto che quell’uomo aveva qualcosa da dire sulla motivazione, sulla gestione della pressione, sulla capacità di far credere le persone in qualcosa di grande. Nel 2010, alla vigilia della semifinale di Champions League contro il Barcellona, disse una cosa che mi rimase impressa: “Noi vogliamo andare dietro al nostro sogno, per loro la finale è un’ossessione – e la differenza è molto grande.”
Quella distinzione – sogno contro ossessione – mi diede una chiave pratica. L’ossessione genera paura del fallimento, blocca il talento, trasforma ogni ostacolo in una conferma che le cose non possono andare bene. Il sogno libera energia, permette di farsi carico di fatiche che altrimenti sembrerebbero insensate. Trassi ispirazione da quella frase per motivare i miei ragazzi. Non come slogan, ma come specchio: state inseguendo un sogno o state cercando di sopravvivere a un’ossessione? Qualcosa si mosse. Anni dopo avrei scoperto che il metodo Kanban descrive esattamente questo approccio: per far evolvere un’organizzazione, il leader si comporta come un allenatore sportivo.
Frankl e il carburante del coraggio
Ma perché funziona? La risposta più profonda non me la ha data il calcio. Me la ha data Viktor Frankl.
Frankl era uno psichiatra viennese. Sopravvisse ad Auschwitz, e da quella esperienza – che non ha paragoni possibili con nessuna difficoltà aziendale, sia chiaro – trasse un’osservazione radicale sulla natura umana: anche privato di tutto, anche ridotto ai minimi termini, un essere umano che riesce a darsi un senso trova la forza di resistere. Chi non lo trova, si sgretola. Non per debolezza morale, ma perché il senso è una necessità costitutiva dell’essere umano, non un lusso. Per riassumere questo concetto Frankl citava spesso Nietzsche:
“Chi ha un perché per vivere, sopporta quasi ogni come.”
Ma Frankl va oltre la resilienza. Propone quella che chiama una rivoluzione copernicana del senso: non dobbiamo chiederci cosa ci aspettiamo dalla vita, ma capire che è la vita a interrogarci.
“Vivere significa rispondere alle domande che la vita ci pone, assumendoci la responsabilità di ogni istante.”
Vivere – e lavorare – non è attendere che le condizioni migliorino. È rispondere, agire, farsi carico.
Ed è qui che senso e coraggio si intrecciano. Senza senso, il costo del coraggio è troppo alto: ci si espone, si rischia, ci si fa carico di qualcosa che potrebbe andare male, e se non si sa perché, a un certo punto ci si ferma. Il senso non è una consolazione, è il carburante del coraggio.
La promessa onesta
Tutto questo ha conseguenze molto concrete su come si gestiscono le persone.
Quando in un’azienda con cui collaboravo anni dopo abbiamo assunto una persona per un ruolo di responsabilità, le condizioni oggettive non erano un argomento di vendita. L’azienda non era strutturata. La retribuzione era bassa. Potevo raccontarle una favola. Non l’ho fatto. Le ho detto con tutta la sincerità che riuscivo a trovare: “Non ti prometto un lavoro facile. Ti prometto anni entusiasmanti a costruire qualcosa che oggi non esiste.” Lei ha scelto quella proposta e quella scelta era un atto di coraggio, non di ingenuità. Il coraggio di chi ha trovato un senso abbastanza solido da giustificare il rischio. Oggi, quando attraversa un momento di sconforto, a volte è utile ricordare insieme quella conversazione. Non come retorica motivazionale, ma come riaggancio al senso originario.
La leadership diffusa nel metodo Kanban
Tutto questo ha un nome preciso nel metodo Kanban: “incoraggia atti di leadership a tutti i livelli.”
Non è un invito a ignorare la gerarchia. È il riconoscimento che la leadership – nel senso di iniziativa, responsabilità, cura del sistema – non può essere monopolio di chi ha un titolo o un ruolo di responsabilità. Un designer che propone un’interfaccia più semplice senza che nessuno glielo abbia chiesto, uno sviluppatore junior che blocca un rilascio perché ha visto un problema che mina la fiducia dell’utente, un team che rifiuta un compito perché non è coerente con lo scopo dichiarato: questi sono atti di leadership diffusa.
Ma attenzione: questo senso non può essere imposto dall’alto. Un purpose scritto dal CEO e affisso in sala riunioni non accende nulla. Il senso che dà coraggio è quello che il team costruisce insieme, attraverso la conversazione, il confronto, la partecipazione alle decisioni. È per questo che Kanban insiste sulla collaborazione e sul rispetto delle persone come condizioni strutturali, non come valori decorativi.
E quando quel senso è davvero condiviso, i comportamenti cambiano. Il coraggio di esporsi, di dire una cosa scomoda, di assumersi la responsabilità di un’azione non richiesta diventa possibile. Senza senso, il costo dell’iniziativa è troppo alto e le persone, razionalmente, si ritraggono. Nel Kanban Maturity Model, questo salto avviene al Livello 3: l’organizzazione smette di rincorrere l’efficienza per sé stessa e inizia a definire uno scopo che orienta ogni decisione. Il fit-for-purpose non è più un’etichetta tecnica, diventa qualcosa che le persone hanno costruito e interiorizzato insieme, e che dà loro il coraggio di agire.
L’unica metrica che conta
La vera metrica del successo di un leader non è un bilancio, un OKR, un NPS.
È quello che succede anni dopo. Alcuni di quei ragazzi con cui lavoravo allora hanno preso strade imprenditoriali. Parlando con loro di recente, ho capito – e uno me l’ha detto esplicitamente – che stanno ancora inseguendo quel sogno. L’azienda è cambiata, il contesto è cambiato, tutto è cambiato. Ma il germe è rimasto.
Se fossi il Faust di Goethe, direi: “attimo, fermati, sei bello!”.
Non perché sia un risultato mio, non lo è. Ma perché significa che il senso che avevamo trovato insieme era reale, abbastanza reale da durare oltre le circostanze che lo avevano generato. E questo, per me, è l’unica eredità che vale la pena costruire.
Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti. Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.
Ogni organizzazione ha riunioni. Poche organizzazioni hanno riunioni che cambiano davvero qualcosa.
Il metodo Kanban prevede un sistema di cadenze – incontri ricorrenti con scopi precisi – progettate per mantenere il flusso di lavoro sotto controllo e far evolvere il sistema nel tempo. Ma c’è un rischio concreto: senza un approccio strutturato al problem solving, le cadenze diventano sessioni di aggiornamento in cui si osservano i problemi senza capirli e risolverli davvero.
L’A3 Thinking è uno strumento che trasforma questo rischio in un’opportunità.
Single-loop e double-loop learning: due modi di imparare
Immagina un termostato. Quando la temperatura scende sotto la soglia impostata, accende il riscaldamento. Quando la raggiunge, si spegne. Il termostato corregge l’errore in modo efficiente, ma non si chiede mai se la temperatura impostata sia quella giusta per chi vive in quella casa.
Questo è il single-loop learning: si rileva uno scarto tra il risultato atteso e quello ottenuto, e si corregge il comportamento. È utile, necessario, e costituisce la base di quasi tutto il miglioramento operativo. Un team che analizza il proprio Lead Time, identifica un collo di bottiglia e modifica un limite WIP sta facendo single-loop learning e lo sta facendo bene.
Il double-loop learning aggiunge una domanda diversa: non “come correggiamo lo scarto?” ma “perché abbiamo impostato quella temperatura?” Nel contesto organizzativo, significa mettere in discussione i modelli mentali e i presupposti che stanno dietro al sistema, non solo le sue regole operative. Non “come gestiamo meglio le urgenze?” ma “la nostra definizione di urgenza riflette davvero le priorità del cliente? Il servizio che stiamo ottimizzando è ancora quello giusto da offrire?”
Nel Kanban Maturity Model, questa distinzione ha un peso preciso. I livelli da ML1 a ML5 si muovono nel territorio del single-loop learning: l’organizzazione impara progressivamente a fare meglio quello che già fa, gestire il flusso, ridurre la variabilità, coordinare servizi interdipendenti. È al livello ML6 che il double-loop learning emerge pienamente, quando l’organizzazione sviluppa la capacità di interrogarsi sulle quattro domande fondamentali: Come lavoriamo è ancora competitivo? Cosa offriamo è ancora rilevante? Perché esistiamo ha ancora senso nel mercato attuale? Chi siamo è ancora adeguato al contesto?
Perché è importante chiarirlo prima di parlare di A3 Thinking? Perché l’A3 è uno strumento potente per il single-loop learning strutturato e questo non è poco. Trasforma le cadenze Kanban da sessioni di aggiornamento in motori di apprendimento sistematico. Ma il suo contributo al double-loop learning, quando arriva, non riguarda la gestione dei blocchi o l’ottimizzazione del Lead Time: riguarda la capacità di usare i dati del sistema per mettere in discussione la direzione stessa dell’organizzazione.
Il Kanban Maturity Model: un’evoluzione per livelli
Il Kanban Maturity Model (KMM) articola la crescita organizzativa in sei livelli e l’A3 Thinking non è rilevante allo stesso modo per tutti i livelli.
Ai livelli ML1 e ML2, dove il lavoro dipende ancora dagli individui e dal loro buon senso, mancano ancora le basi – dati affidabili, policy esplicite, cultura del feedback – per usarlo efficacemente. È a partire da ML3, quando l’organizzazione arriva a gestire il lavoro come un vero sistema end-to-end, che l’A3 diventa uno strumento di evoluzione reale, ed è ai livelli superiori che esprime tutto il suo potenziale come motore di single-loop learning strutturato, costruendo le fondamenta su cui, a ML6, può emergere il double-loop learning.
Cos’è l’A3 Thinking (e come si usa nelle cadenze Kanban)
L’A3 Thinking è un metodo di problem solving sviluppato in Toyota. Il nome viene dal foglio di carta formato A3: l’idea originale era che un problema – dalla descrizione alla soluzione – dovesse stare tutto su un singolo foglio. Non per superficialità, ma per disciplina. È una forma di slow thinking, pensiero lento e profondo: se non riesci a sintetizzare un problema su una pagina, probabilmente non lo hai ancora capito abbastanza bene.
Il template si compone di cinque sezioni, distribuite su un foglio A3 o su fronte e retro di un foglio A4.
Definizione del problema. Prima ancora di cercare soluzioni, bisogna capire cosa si sta osservando e perché conta. Nelle cadenze di revisione periodica – la Service Delivery Review o la Risk Review – questa è la domanda di apertura: qual è il gap tra la performance attuale del servizio e quello che il cliente si aspetta? Definire bene il problema in questa fase evita di sprecare energie su sintomi invece che su cause.
Analisi del problema. È la sezione più importante, e quella più spesso saltata. L’analisi non si fa a parole, ma con i dati di flusso: quanto tempo impiega mediamente un elemento di lavoro ad attraversare il sistema? Dove si accumula? Quanto tempo passa in attesa rispetto al tempo in cui qualcuno ci sta lavorando davvero? Il modo più efficace per rispondere a queste domande non è scrivere una lista di osservazioni, ma incollare direttamente sul foglio A3 i grafici che raccontano la storia: un Cumulative Flow Diagram (CFD) che mostra dove il lavoro si accumula, un grafico di Lead Time che rivela la variabilità del sistema, un aging chart che evidenzia cosa è fermo da troppo tempo. L’A3 non è un documento di testo con qualche numero: è uno strumento visivo, e la differenza si vede.
Nelle cadenze operative – il Kanban Meeting quotidiano – questa mentalità analitica serve a leggere i blocchi non come eccezioni da risolvere in fretta, ma come segnali che raccontano qualcosa sul sistema. La domanda non è “chi lo sblocca?”, ma “perché si è bloccato?”.
Esperimento e piano di implementazione. Una volta identificata la causa, si progetta un intervento – non una soluzione definitiva, ma un esperimento. Questa distinzione è importante: un esperimento ha un’ipotesi verificabile (“se modifichiamo il limite di lavoro in corso in questo punto, il tempo di attraversamento dovrebbe ridursi”), mentre una soluzione è spesso solo un’opinione con più autorevolezza. Il piano di implementazione definisce chi fa cosa, in quale cadenza si osserveranno i risultati, e quali metriche si useranno per giudicare se l’esperimento ha funzionato. Un esperimento per volta, altrimenti non si riesce a capire cosa ha funzionato e che cosa no.
Risultati dell’esperimento. La cadenza naturale per questa sezione è la Service Delivery Review: si torna sui dati dopo un ciclo sufficiente a produrre segnale, e si misura l’effetto reale dell’intervento. Anche qui, i risultati non si raccontano a parole: si mostrano. Lo stesso grafico usato nell’analisi, aggiornato dopo l’esperimento, dice immediatamente se qualcosa è cambiato e in che direzione. Se il Lead Time si è stabilizzato, il CFD mostra bande più uniformi, se si è ridotto l’aging chart ha meno elementi in zona critica. La continuità visiva tra analisi e risultati è parte del metodo: rende evidente il confronto e riduce lo spazio per le interpretazioni di comodo. Questo passaggio è quello che trasforma un’opinione in apprendimento. Senza di esso, il sistema non impara, accumula solo iniziative.
Prossimi passi. Se l’esperimento ha funzionato, il risultato non è “problema risolto” ma “nuova policy da codificare”. Una regola di ingresso rivista, un criterio di priorità esplicitato, una soglia di allerta definita. È qui che il cambiamento smette di dipendere dalla memoria delle persone e diventa parte del sistema. Se invece l’esperimento non ha prodotto i risultati attesi, i prossimi passi riportano all’analisi con nuove informazioni.
Questa struttura ciclica è ciò che distingue l’A3 da una normale checklist: non si compila una volta, si percorre più volte, ciascuna con una comprensione più profonda del problema.
Il problema che l’A3 risolve nelle cadenze Kanban
Nelle organizzazioni ai livelli ML1 e ML2, i problemi vengono ancora affrontati in modo reattivo: è single-loop learning, ma applicato in modo caotico e inconsapevole, senza che l’organizzazione ne tragga apprendimento stabile.
Il salto verso ML3 non è un salto verso il double-loop learning: è il passaggio a un single-loop learning maturo, strutturato e consapevole. L’A3 Thinking può supportare questo passaggio spostando il focus dalle persone al sistema. La domanda non è “chi ha sbagliato?” ma “cosa nel nostro modo di lavorare produce questo risultato?” È una distinzione che Deming aveva reso famosa decenni fa, e che ancora oggi fatica a entrare nella cultura di molte aziende.
Ai livelli ML4 e ML5, quando le decisioni si basano su modelli probabilistici e il miglioramento si estende oltre i confini del singolo team, l’A3 consolida questo percorso: aiuta a orchestrare il miglioramento tra servizi interdipendenti, a gestire il rischio in modo strutturato, a rendere l’apprendimento operativo una pratica normale e non un evento eccezionale. Sempre nell’ambito del single-loop learning, ma portato alla sua massima maturità, come preparazione al salto qualitativo che avviene a ML6.
Dall’analisi alla policy: il cambiamento che rimane
Un problema risolto una volta non è un problema risolto. Lo è solo quando la soluzione viene codificata in una regola esplicita che il sistema segue anche quando chi ha trovato la soluzione non c’è più.
L’A3 Thinking, in questo percorso, è uno strumento che aiuta a costruire le fondamenta. Senza la disciplina del single-loop learning strutturato – senza la capacità di analizzare, sperimentare e codificare – il double-loop rimane un esercizio intellettuale senza radici operative. Le organizzazioni che arrivano a ML6 non saltano i livelli precedenti: li attraversano, e l’A3 è parte di come lo fanno.
Una nota finale
W. Edwards Deming diceva che l’apprendimento non è obbligatorio, così come non lo è la sopravvivenza. L’A3 Thinking nelle cadenze Kanban non è una tecnica sofisticata riservata alle organizzazioni avanzate. È il modo in cui si fa sul serio con il miglioramento continuo a partire da ML3: guardare i dati, capire il sistema, cambiare le regole. E ricominciare.
Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti. Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.
In molte organizzazioni, quando si parla di produttività degli uffici, si parte da un’intuizione apparentemente ragionevole: se le persone sono occupate, il lavoro avanza. Se le ore registrate aumentano, la produttività aumenta. Peccato che questa logica, portata alla prova dei dati, si riveli quasi sempre sbagliata.
Il problema dell’effort
Misurare le ore di lavoro – l’effort – dice quanto tempo le persone hanno dedicato a qualcosa. Non dice quanto lavoro è stato effettivamente completato. Sono due cose diverse, e confonderle genera decisioni sbagliate.
Un ufficio che gestisce pratiche amministrative può essere pieno di persone impegnate tutto il giorno, eppure produrre meno output di un ufficio più snello e meno saturo. Il motivo è semplice: quando le persone sono troppo occupate, il sistema si inceppa alla minima perturbazione – una richiesta urgente, un’assenza, una dipendenza esterna. Il lavoro si accumula, i tempi si allungano, e nessuno capisce esattamente perché.
La misura che conta, invece, è il Throughput: quante pratiche vengono effettivamente completate in un dato periodo. Registrazioni, contratti, acquisti, variazioni – qualsiasi cosa rappresenti un’unità di lavoro conclusa. Se il Throughput aumenta a parità di organico, la produttività sta crescendo. Non ci sono interpretazioni: è un dato empirico, diretto, semplice da raccogliere.
Livelli di servizio: sapere non basta, bisogna collegare
Una volta che si inizia a misurare il Throughput, emerge naturalmente una seconda domanda: in quanto tempo completiamo le pratiche? È qui che entrano in gioco i Service Level Agreement (SLA), ovvero gli impegni misurabili che un ufficio può comunicare ai propri interlocutori interni ed esterni.
Un esempio concreto: l’ottantacinquesimo percentile dei Lead Time è di 15 giorni. Che in termini semplici significa: l’85% delle richieste di un determinato servizio viene gestito entro 15 giorni. È un dato reale, ricavato dai sistemi in uso, ma da solo non dice ancora nulla di utile. La domanda che conta non è “è tanto o è poco?”, ma: qual è l’impatto reale sull’organizzazione se questi tempi restano invariati, si allungano, o si accorciano?
Senza questa misura di impatto, qualsiasi target è arbitrario. Fissare un obiettivo di 8 giorni invece di 15 potrebbe essere un miglioramento significativo o uno spreco di risorse, dipende da cosa succede a valle. Finché non colleghiamo le metriche operative alle conseguenze organizzative, stiamo ottimizzando nel vuoto.
Questo è il nodo: spesso non è che manchino i dati. Manca il collegamento tra i dati e le decisioni.
Gestire i picchi con i dati storici
Molte organizzazioni di servizio, e anche molti uffici amministrativi, vivono di stagionalità: certi periodi dell’anno concentrano volumi di lavoro molto superiori alla media. Pensate per esempio un ufficio paghe: avrà dei picchi di lavoro da evadere in corrispondenza di ogni fine mese.
Il modo tradizionale di gestire questi picchi è reattivo: si aspetta che il sistema si inceppi, poi si aggiunge personale o si fanno straordinari. Il modo alternativo è usare i dati storici per anticipare i picchi e attivare risorse aggiuntive – interne o esterne – solo quando e dove servono davvero. Una capacità extra controllata invece di un’emergenza ricorrente.
Capacity planning: vedere la coperta prima che sia troppo corta
Quando un ufficio gestisce attività diverse, la sfida non è solo fare di più, ma bilanciare. La coperta è sempre potenzialmente corta, e senza una mappa dell’allocazione reale delle risorse è impossibile sapere dove concentrare l’attenzione.
La settimana tipo è uno strumento semplice: si mappa come viene effettivamente distribuito il tempo del team tra le diverse categorie di attività, e si confronta questa distribuzione con i volumi di lavoro in arrivo. Questo confronto rende visibili i colli di bottiglia prima che diventino crisi, e permette di spostare risorse in modo consapevole invece di rincorrere le urgenze.
C’è un ultimo problema, forse il più sottovalutato: il lavoro invisibile. In ogni ufficio esiste una quota significativa di attività che non viene tracciata – richieste gestite via email, richieste urgenti, eccezioni, supporto informale. Questo lavoro sommerso consuma capacità reale, ma non appare in nessuna metrica. Risultato: le analisi partono da dati incompleti, e le decisioni che ne derivano sono distorte.
La soluzione non è burocratizzare ogni attività, ma rendere visibile almeno la massa del lavoro sommerso – anche in modo aggregato – per avere una visione sistemica e bilanciata della situazione.
Le cadenze: dove avviene il vero miglioramento
Tutto questo – throughput, SLA, capacity planning, visibilità sul lavoro sommerso – è necessario ma non sufficiente. Le metriche contano solo se vengono usate con regolarità per fare domande precise: cosa sta cambiando? Cosa proviamo a migliorare? Come misuriamo se l’intervento ha funzionato?
Questo è il principio del miglioramento continuo: non un progetto straordinario, ma un meccanismo ordinario. Si fissa una cadenza di revisione – settimanale, bisettimanale, mensile – si guardano i dati, si formula un’ipotesi di miglioramento, si prova, si misura l’effetto. Se funziona, si consolida nel metodo. Se non funziona, si cambia strada.
È un metodo forse noioso da farsi, ma sorprendentemente foriero di risultati nel tempo.
In sintesi
Cosa misurare
Perché
Throughput
Misura il lavoro realmente completato, non l’occupazione di tempo
Lead time / SLA
Permette di prendere impegni misurabili con gli interlocutori interni ed esterni
Distribuzione per attività
Rende visibili i colli di bottiglia e bilancia i carichi
Volume storico
Permette di anticipare i picchi invece di subirli
Cadenze di revisione
Trasforma i dati in decisioni e iniziative di miglioramento continuo
Nessuno di questi strumenti richiede tecnologie complesse. Richiedono disciplina, continuità, e la disponibilità a prendere decisioni basate sui dati invece che sulle sensazioni. Il metodo Kanban offre esattamente questo: un sistema di pratiche, cadenze e metriche progettato per rendere tutto ciò ordinario – non un progetto straordinario, ma il modo normale di lavorare.
Un’ultima cosa: non è una questione di settore
C’è una storia che vale la pena raccontare, perché smonta un alibi molto comune.
Toyota è oggi il produttore di auto più grande al mondo. Produce 2 milioni di auto in più rispetto a Volkswagen (11 milioni circa contro 9 milioni circa), con circa la metà del personale. Non è successo perché fanno auto, perché sono giapponesi, o perché hanno avuto accesso a tecnologie particolari. È successo perché hanno applicato per più di settant’anni con rigore e continuità il metodo scientifico ai propri processi: osservare, misurare, formulare un’ipotesi, sperimentare, misurare di nuovo. Consolidare ciò che funziona, abbandonare ciò che non funziona. Ricominciare.
Chi dice “da noi non funzionerebbe, il nostro settore è diverso” di solito non sta descrivendo una realtà, sta descrivendo una resistenza. Il metodo scientifico non conosce settori. Funziona dove si è disposti a guardare i dati e a cambiare idea quando i dati lo chiedono.
Un ufficio amministrativo o una organizzazione di servizi non è una fabbrica di automobili. Ma le domande sono le stesse: quanto lavoro stiamo completando? In quanto tempo? Dove si accumula? Cosa succede se cambiamo qualcosa? La differenza tra chi migliora e chi resta fermo non è mai nella complessità degli strumenti, è nella disponibilità a fare quelle domande ogni settimana, senza mai smettere.
Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti. Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.