“Marco, stiamo per introdurre l’intelligenza artificiale. Vedrai, ci sistema tutto.”
È la frase che mi sento dire quasi sempre quando entro in un’azienda in affanno, ed è quella che mi preoccupa di più. L’AI è un moltiplicatore, e un moltiplicatore non ha un segno suo: prende quello che trova.
Questa prima puntata è il manifesto della serie. Racconto tre effetti che si vedono davvero quando la velocità arriva su un sistema che non era pronto, uso l’immagine del megafono e lascio una domanda da farsi prima di introdurre l’AI. Non “cosa può fare per me?”, ma un’altra, che scoprirai ascoltando l’episodio.
“Prima il Flusso, poi l’AI” è una serie di dieci storie vere di organizzazioni. Esce una puntata ogni due settimane, il lunedì, e puoi ascoltarla sulla piattaforma che usi di solito. Se arrivi adesso, conviene partire dal primo episodio: le storie si richiamano l’una con l’altra e le piattaforme mostrano per primo l’episodio più recente:
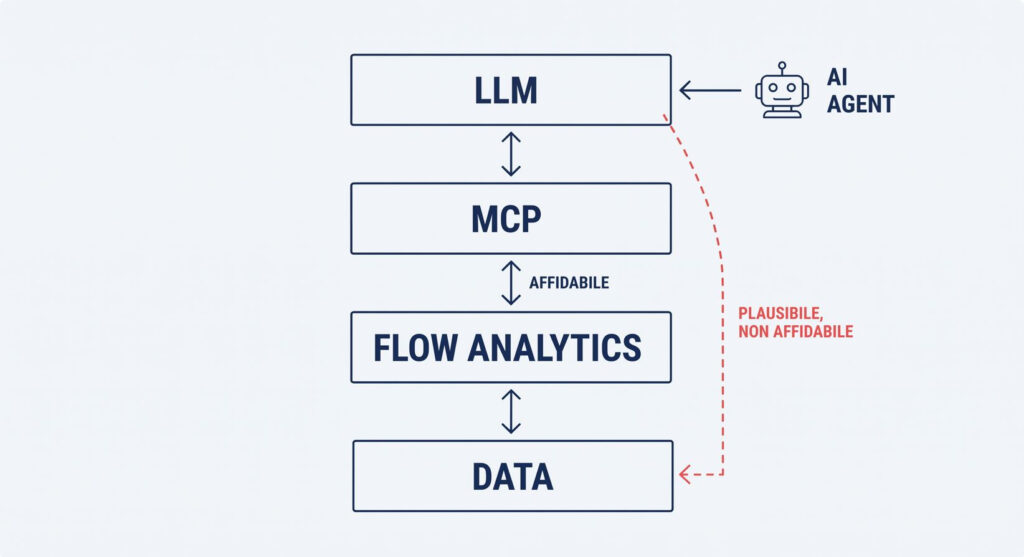
Al ritorno dal Kanban Leadership Retreat, ho scritto un articolo, “Perché collegare l’AI ai vostri dati di flusso non basta: le decisioni che qualcuno deve prendere”, su un tema che al retreat aveva occupato molto spazio: qual è la corretta architettura per introdurre l’AI in un sistema Kanban. La conclusione era che un agente AI da solo non basta, e che le cose vanno peggio se accede direttamente ai dati grezzi di flusso e li elabora in autonomia. Si ottiene una risposta plausibile ma non affidabile, che cambia quando cambia il workflow senza che nessuno se ne accorga.
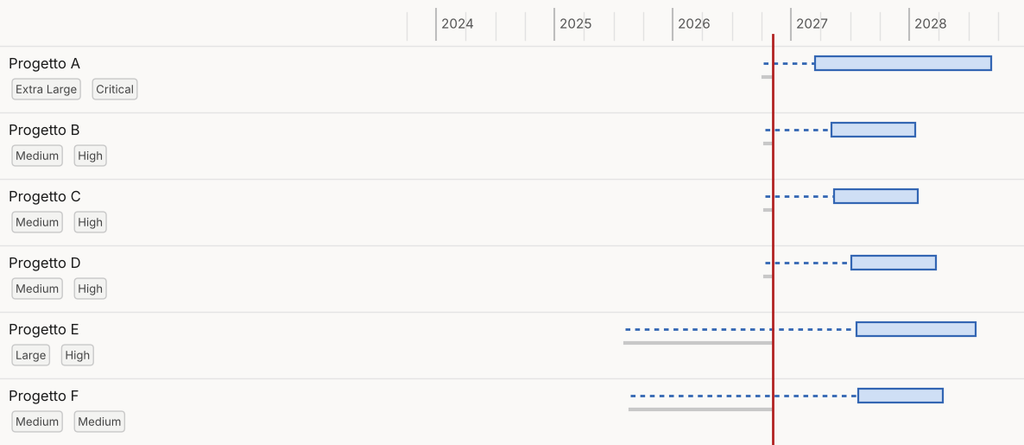
Il ruolo giusto per l’AI è quello di interfaccia di un motore di flow analytics, che applica sempre le stesse definizioni di misura, con una persona (lo human in the loop) che quelle definizioni le ha decise e le mantiene. Nelle ultime settimane abbiamo applicato questa architettura a un lavoro vero: il Rolling Forecast dei progetti collegato al sistema Kanban di un’organizzazione.
Nel caso specifico su cui abbiamo lavorato, il Rolling Forecast è collegato a un sistema Kanban di portfolio progetti e ne recepisce le policy. Ogni progetto ha una taglia assegnata, e la durata attesa si ricava dall’85° percentile dei progetti già completati della stessa taglia. I progetti in coda si ordinano per priorità, poi per scadenza, poi per ordine di arrivo. Un progetto parte quando c’è capacità, ovvero un posto libero nei limiti al lavoro in corso, sia quello complessivo sia quelli delle singole persone assegnate. Quando un progetto finisce, il posto si libera e il successivo può partire. Il risultato è per ogni progetto una data di inizio e una di fine attese, che si ricalcolano quando cambiano i dati.
Due motori, un’AI e una persona
L’architettura nel nostro caso ha due motori. Il primo è il sistema Kanban in cui il lavoro è gestito, basato su Kanban Zone, che gestisce il flusso, raccoglie gli eventi e restituisce dati puliti: date di ingresso e uscita dalle colonne, taglie dei progetti, assegnatari. È lui il motore di flow analytics di cui parlavo nell’articolo precedente.
Il secondo motore non esisteva e l’abbiamo creato: un motore di calcolo del Rolling Forecast. Legge i dati del sistema Kanban e fa il forecast di pianificazione in funzione della capacità disponibile. Avremmo potuto chiedere il Rolling Forecast direttamente all’AI, che lo avrebbe dato per approssimazione statistica, ma non lo abbiamo fatto. Invece ci siamo fatti aiutare dall’AI a costruire un motore algoritmico, come il sistema Kanban, che faccia i calcoli corretti. Le regole che usa, cioè il percentile per ogni taglia, l’ordine in coda e i limiti per persona, sono scritte in un file di configurazione che chiunque può leggere. Non sono nascoste nella testa di chi pianifica, e non dipendono da come un’AI interpreta i dati.
Accanto a ogni regola il file indica da dove viene: dalla board, dal lavoro di pianificazione già esistente, oppure da un’ipotesi. Chi ha la responsabilità del sistema può quindi leggere una regola, discuterla, cambiarla, e il motore ricalcola applicandola sempre allo stesso modo. Sopra i due motori lavorano l’AI e la persona, con compiti diversi: li descrivo nella sezione successiva.
Chi fa cosa
I due motori calcolano, sempre allo stesso modo sugli stessi dati. Se un numero cambia, è perché sono cambiati i dati o è cambiata una regola scritta, mai perché qualcuno ha interpretato i dati in modo diverso. L’AI non calcola. Confronta i dati e gli output dei due motori, mette in evidenza le incongruenze e aiuta a riconoscere i pattern che in un elenco lungo non si vedono a occhio. La persona decide le regole e analizza l’esito del confronto.
Rispetto all’articolo precedente c’è un elemento in più, che è opportuno tenere distinto. L’AI ha scritto il codice del secondo motore, e la persona l’ha controllato e testato sulla board, verificando che l’output fosse quello previsto dalle regole.
Cosa è emerso
Il confronto fatto dall’AI sui dati dei due motori ha fatto emergere alcune domande che fino a quel momento erano rimaste implicite. Alcuni esempi danno bene l’idea di come funziona.
Il primo riguarda il momento in cui finisce il progetto. Un progetto completato, poi riaperto e chiuso di nuovo, risultava con due durate molto diverse a seconda di quale chiusura si considerava. Il motore di calcolo del Rolling Forecast ne sceglieva una per convenzione, e l’AI ha messo in evidenza l’incongruenza del dato. Cosa significhi “finito” per un lavoro che torna indietro è una policy di processo, e la scelta spetta a una persona.
Il secondo riguarda i limiti per persona. La policy della board fissa un numero massimo di progetti per ciascuna persona, ma non dice cosa fare quando un progetto è assegnato a più persone. Il motore di calcolo del Rolling Forecast ha bisogno di una regola per prevedere, e nella configurazione è stato necessario scriverne una, che per ora resta un’ipotesi: un progetto condiviso vale per ciascuno una frazione, da definire. L’AI ha messo in evidenza l’incongruenza tra ciò che la policy dice e ciò che il calcolo richiede. Completare la policy spetta a una persona.
Il terzo riguarda la durata attesa, che si ricava dal percentile dei progetti già completati della stessa taglia. Qui le incongruenze erano più d’una: i valori che avevamo ipotizzato inizialmente e quelli misurati non coincidevano per alcune taglie, il percentile si spostava molto a causa di pochi progetti lunghi, e due taglie quasi non si distinguevano per durata. Su quale base calcolare un valore su cui impegnarsi è una decisione ancora aperta che spetta a una persona.
Il confronto serve a capire
L’analisi fatta con il supporto dell’AI mette in evidenza le incongruenze, di qualunque tipo siano, e lo fa individuando dei pattern che in un insieme articolato di dati difficilmente si vedono a occhio. Ma l’AI si ferma lì: segnala delle incongruenze e può suggerire dei perché.
Ogni incongruenza può avere più cause. Può mancare una policy che il motore non conosce, perché esiste già nella pratica ma nessuno l’ha mai scritta. Può non essere aggiornata la board. Oppure può servire una policy nuova, che finora nessuno aveva avuto bisogno di definire e che il calcolo ha reso necessaria. Capire quale sia la causa, e quindi cosa fare, è il compito della persona che conosce davvero il sistema. L’analisi fatta con il supporto dell’AI le dà il punto da cui partire per evolvere il sistema, e la comprensione resta della persona.
Solo dopo aver capito arrivano le decisioni: introdurre una nuova policy, completarne una esistente, aggiornare la board. Ogni decisione di questo tipo rende il funzionamento del sistema più coerente, e le esecuzioni successive dei motori lo riflettono.
Conclusione
Il caso mostra all’opera l’architettura di cui scrivevo nell’articolo precedente: i motori calcolano su dati puliti, l’AI confronta e individua i pattern, la persona capisce e decide. Le incongruenze emerse riguardano il funzionamento del flusso e le policy del sistema: dove finisce un progetto, come si conta un limite, su quale base si stima una durata. Sono emerse perché i motori applicano sempre le stesse regole e il calcolo ne richiede di esplicite. Rieseguiti sugli stessi dati, producono gli stessi output, e le stesse incongruenze restano visibili. Usando i dati grezzi un’AI avrebbe potuto notarne qualcuna, ma senza regole stabili a ogni domanda avrebbe potuto dare una risposta diversa.
C’è poi un’aggiunta rispetto all’articolo precedente, che riguarda un possibile uso dell’AI: l’AI ha abbassato il costo di costruire un pezzo di motore che mancava, lasciando però il controllo alla persona.
Ora i due motori girano insieme. A ogni esecuzione producono dati su cui l’AI individua i pattern, e la persona li usa per capire e migliorare il sistema.
Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti. Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.
Questa edizione della newsletter racconta un progetto nuovo.
Nell’ultima edizione chiedevo cosa serve prima dell’AI. Gli articoli delle scorse settimane, dallo studio legale al keynote di David Anderson, dalla sessione di Sonya Siderova alla previsione statistica, tornavano tutti allo stesso punto: l’intelligenza artificiale accelera il lavoro, ma non crea ordine dove non c’è.
Una risposta la dà sempre, sicura e ben presentata. Ma se il lavoro non è tracciato e nessuno ha deciso cosa misurare, quella risposta è plausibile, non affidabile. L’AI non aggiusta ciò che trova, lo amplifica: dove c’è flusso moltiplica valore, dove c’è caos moltiplica il caos.
In chiusura avevo scritto che a questo tema avrei dedicato un podcast. Eccolo.
Il podcast
Si chiama “Prima il Flusso, poi l’AI”, e il titolo è già la risposta a quella domanda. È uno spin-off di “Lavoro Meglio con l’AI” di Leonarda Vanicelli: lo abbiamo ideato e prodotto insieme, io ne sono la voce narrante.
Sono dieci storie vere di organizzazioni, una per puntata. Niente teoria astratta, niente tecnicismi: episodi brevi e concreti, ognuno con un’idea da usare subito nel proprio lavoro. Storie diverse, con la stessa domanda di fondo: dove si blocca il lavoro, e cosa cambia quando lo si fa scorrere. Prima le persone e il modo in cui lavorano, poi gli strumenti.
Quando
Il trailer è già online. La prima puntata esce lunedì 9 novembre, poi una ogni due settimane, sempre di lunedì.
Pochi giorni fa, durante l’Officina del Kanban, una persona mi ha chiesto più volte perché dovrebbe dotarsi di metriche. Aveva costruito il suo sistema Kanban con cura e non ne sentiva il bisogno. Le ho chiesto a mia volta come fa a sapere quando il lavoro viene consegnato e la risposta è stata semplice: lei lo sa già, perché assegna il lavoro a ciascuno dei membri del team, e sono loro a comunicarle quando consegnano. Sono bravi e affidabili, quindi si fida di ciò che dicono.
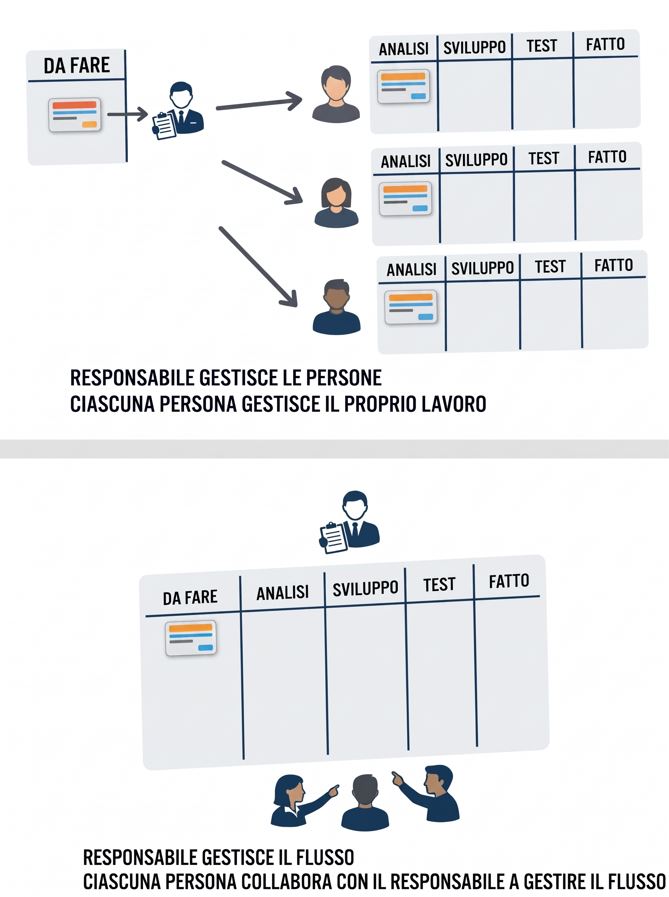
Questa risposta mi ha fatto capire la reale situazione. Quella persona gestisce le persone e non il flusso, e il passaggio dall’una all’altra gestione è esattamente ciò che nel Kanban Maturity Model (KMM) separa il livello di maturità 0 dal livello 1. L’immagine che accompagna l’articolo ne mostra i due estremi.
Un sistema che regge finché le persone restano
Nella parte alta dell’immagine il lavoro da fare arriva al responsabile, che lo assegna alle persone, e ciascuna lo gestisce per conto proprio. Ognuno può avere la sua Kanban board, ma in pratica funziona come un’azienda indipendente. Una volta l’ho detto a un imprenditore che mi descriveva questo modo di lavorare: hai un’azienda di dieci persone, ma è come se avessi dieci aziende che lavorano in parallelo. Le persone non sanno cosa fanno le altre, quindi non esiste un vero lavoro di squadra, e il responsabile gestisce le persone più che il lavoro.
Finché le persone sono brave il sistema produce risultati, ed è per questo che chi lo adotta non sente la necessità di cambiare. Il suo limite è che dipende interamente dalle persone, e questo lo rende fragile. Una settimana di ferie ferma il lavoro di chi è assente, perché nessun altro lo ha in mano. Un’influenza lo rallenta e le dimissioni lo bloccano del tutto. Per lo stesso motivo il sistema scala con difficoltà: per crescere serve un altro collaboratore bravo, e finché non arriva l’organizzazione non cresce.
Torno così alla domanda sulle metriche. La fiducia nei singoli membri del team è ben riposta finché restano loro. Se uno si dimette e ne arriva un altro, quella fiducia non c’è ancora, e per costruirla occorre rilevarne le misure, che cambiano da persona a persona. Le metriche servono quindi in ogni caso, anche se in un sistema di questo tipo si fatica a percepirne il bisogno.
Gestire il flusso
Nella parte bassa dell’immagine la situazione cambia. La board è una sola, il responsabile gestisce il flusso e ciascuna persona collabora con lui per farlo avanzare. Non esistono più il lavoro mio, il lavoro tuo e quello di un altro, perché il lavoro è condiviso e ognuno ne è in parte corresponsabile. Il responsabile resta il titolare dell’accountability, ma ora il lavoro attraversa una sorta di catena di montaggio, una filiera intorno alla quale le persone si organizzano.
Nel KMM questo percorso si sviluppa in più tappe. A ML1 nasce il team, perché le persone iniziano a collaborare sugli stessi compiti. A ML2 compare il ruolo di Flow Manager, cioè di chi presidia il flusso: raccoglie le metriche, fa rispettare i limiti al lavoro in corso e facilita la risoluzione dei blocchi. Come ho descritto nell’articolo Come funziona Kanban: il Flow Manager per migliorare la gestione del flusso di lavoro, è un ruolo da svolgere più che un titolo: può assumerlo il responsabile, oppure un membro del team che si è offerto e ha le competenze adatte.
Un sistema meno fragile e più scalabile
Il sistema che ne risulta è meno fragile. Quando una persona manca, anche solo per un periodo, le altre possono prendere in carico il suo lavoro, perché in parte lo hanno già in carico. È anche più scalabile, perché chi arriva si inserisce in un sistema che procede da solo e ha una propria fisionomia, e contribuisce a gestire il lavoro senza doversi organizzare un flusso proprio.
C’è poi un’altra ragione. In un sistema così le persone più brave, che prima svolgevano il lavoro, possono evolvere e fare il jolly: non prendono lavoro in carico direttamente, ma si muovono su tutto il flusso e aiutano gli altri, in particolare i più junior, a crescere e a lavorare bene. Così chi arriva trova qualcuno che lo accompagna, e l’organizzazione può crescere senza aspettare un altro collaboratore già esperto.
Un sistema che forma nuovi manager
Si dice spesso che per crescere una persona debba diventare manager. Di frequente, però, la promozione si riduce a un nuovo titolo sul biglietto da visita, senza che nessuno le insegni il mestiere del manager.
Un sistema che evolve da ML0 a ML3 offre un’alternativa. Le persone che si vogliono far crescere imparano il mestiere lavorando con gli strumenti del flusso: leggono le metriche, gestiscono i limiti al lavoro in corso, facilitano la risoluzione dei blocchi. Quando poi diventano responsabili o assumono il ruolo di Flow Manager, quel mestiere lo conoscono già. Gestire il flusso non toglie spazio alle persone: è il modo in cui si insegna loro a diventare manager.
L’effetto sull’intelligenza artificiale
Il passaggio dalla gestione delle persone alla gestione del flusso ha una conseguenza anche sull’uso dell’intelligenza artificiale. Quando i flussi sono tanti quante sono le persone, le attività si duplicano. Se per esempio ciascuno fa la propria analisi e se la ottimizza con l’AI, lo stesso lavoro viene ripetuto molte volte. L’AI consuma token e il costo dipende proprio da quelli, per cui in un’azienda di qualche decina di persone che ripetono la stessa operazione il costo si moltiplica per il numero di persone coinvolte. Con un flusso unico l’analisi è una sola, e se serve l’AI la si applica lì.
Un flusso unico rende anche visibile il collo di bottiglia. Con tanti flussi i colli di bottiglia sono altrettanti e dipendono dalle persone, per cui non si capisce dove intervenire. Quando invece il collo di bottiglia è individuato, l’AI trova la sua collocazione corretta. Se la si mette a monte, intasa ancora di più il collo di bottiglia. Se la si mette a valle, si spreca la sua potenzialità, perché non si accelera nulla che sia già scarico.
C’è infine una possibilità in più. In un flusso unico si può provare a usare l’AI come attore del team, un agente che lavora con le persone, aiuta a orchestrare il flusso e a renderlo più efficiente. Dove il flusso non esiste però, non c’è nulla da orchestrare.
L’effetto sulla qualità
Un’ulteriore conseguenza riguarda la qualità. Dove il responsabile gestisce le persone, la qualità dipende da a chi viene assegnato il lavoro: se arriva a una persona brava il risultato è buono, se arriva a una meno brava lo è meno. Quando si passa a gestire il flusso, la qualità tende a dipendere sempre meno dalle singole persone e sempre più dal modo in cui il flusso funziona.
Avviene gradualmente man mano che il sistema evolve. A ML2 il risultato dipende ancora dall’impegno eroico dei manager. A ML3 la qualità non è più legata né agli eroismi individuali né a quelli manageriali, ma a una gestione del flusso consistente. Le persone continuano a essere più o meno brave, ma è il sistema nel suo insieme a determinare il risultato.
Perché le metriche servono sempre
Tornando alla persona dell’Officina, la sua fiducia nei singoli membri del team è giustificata finché sono loro a lavorare, ma non si trasferisce a chi arriva dopo. Le metriche servono comunque, e cambia solo il motivo. In un sistema che gestisce le persone servono per decidere se fidarsi di ciascuna, in un sistema che gestisce il flusso servono per gestirlo.
Conclusione
Il passaggio dalla gestione delle persone alla gestione del flusso è un cambio di paradigma organizzativo, non una questione di strumenti. Si parte da ML0, dove il responsabile assegna il lavoro e ciascuno se lo gestisce. A ML1 nasce il team e il responsabile smette di gestire le persone per occuparsi del flusso, a ML2 questo presidio diventa il ruolo di Flow Manager e a ML3 la qualità dipende dal flusso e non più dagli eroismi di persone o manager.
Le conseguenze sono concrete. Il sistema è meno fragile e più scalabile, perché il lavoro è condiviso e non dipende più da una sola persona. L’AI non viene duplicata da ciascuno per supportare le proprie attività ma si applica una volta sola, nel punto in cui il flusso ne ha bisogno. La qualità smette di dipendere da a chi viene assegnato il lavoro. Infine il sistema non rende le persone meno importanti: è il modo in cui si insegna loro il mestiere del manager, invece di limitarsi a promuoverle. Per migliorare non basta chiedersi quanto siano bravi i singoli: serve capire come funziona il flusso in cui lavorano e dare loro gli strumenti per poterlo gestire efficacemente.
Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti. Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.
Ho appena terminato di tenere un corso ITIL 5 Foundation. Mentre raccontavo le otto attività del nuovo ciclo di vita dei prodotti e dei servizi, a ciascuna era associato un elenco di metriche di successo, e continuavo a vedere passare metriche che conosco molto bene: sono quelle tipiche dei sistemi Kanban. Avrei voluto fermarmi a raccontare cosa dice il Kanban Maturity Model (KMM) su quelle misure. Chi segue un corso come questo spesso vorrebbe anche capire come si fa nella pratica, ma un corso ITIL deve attenersi al contenuto dell’esame e non è il luogo per approfondire la parte pratica. Allora provo a farlo in questo articolo, almeno per dare qualche spunto.
Un secondo punto mi ha fatto riflettere durante il corso. ITIL 5 collega l’intelligenza artificiale alla visione olistica, quella che in Kanban chiamiamo visione sistemica (Systems Thinking), e all’individuazione dei colli di bottiglia, e dice che i miglioramenti del flusso vanno concentrati proprio lì. È un buon punto di partenza. Io ci aggiungo dove applicarla concretamente: a monte del collo di bottiglia intasa ancora di più, a valle accelera qualcosa che non ne ha bisogno. In aula ho fatto un breve accenno al concetto, qui vorrei provare a spiegarlo meglio.
Cosa introduce ITIL 5
ITIL 5 introduce un modello di ciclo di vita di prodotti e servizi digitali con otto attività: Discover, Design, Acquire, Build, Transition, Operate, Deliver, Support. ITIL precisa che non vanno eseguite come un ciclo: dal punto di vista dell’organizzazione formano la catena del valore, cioè l’insieme delle attività che abilitano il valore. Ogni organizzazione ne include alcune o tutte e le combina, secondo il proprio contesto, nei flussi del valore (value stream).
La novità rispetto a ITIL 4 è che a ciascuna attività è associato un elenco di metriche chiave di successo. In ITIL 4 le metriche stavano nelle pratiche. Cycle time, wait time e lead time c’erano già, ma a livello di flusso e di pratiche, non di attività.
Guardando l’insieme delle metriche, alcune saltano all’occhio. La soddisfazione compare in tutte e otto le attività: quella degli stakeholder in sette, quella di clienti e utenti in Deliver e in Support. L’aderenza alla roadmap o alla strategia in sette. Un tempo esplicito compare in quattro: Design, Acquire, Build e Transition, a cui si aggiunge la velocità di ripristino in Support. Discover, Operate e Deliver non hanno nessuna metrica di tempo.
Le metriche e il Kanban Maturity Model
Le corrispondenze con il KMM sono molte.
Per la transizione ITIL misura il numero e l’impatto degli errori di transizione, cioè dei rilasci andati male. Un rilascio andato male genera rilavorazioni, e il lavoro che ne nasce nel KMM si chiama failure demand: la domanda che arriva perché la qualità iniziale non bastava.
Per la qualità ITIL misura specifiche, risorse e soluzioni. Nel KMM la qualità si misura sul risultato finale: la quota di richieste consegnate senza rilavorazione. Quando si registra una rilavorazione, occorre risalire a quali specifiche, risorse o soluzioni l’hanno generata.
Per Deliver e Support ITIL misura la performance rispetto agli SLA concordati. Nel KMM corrispondono la puntualità di consegna e gli impegni di servizio basati sui percentili di lead time.
Per la soddisfazione di stakeholder, clienti e utenti ITIL ha una misura in ogni attività. Nel KMM corrispondono gli indicatori di fitness for purpose, ricavati dai criteri con cui il cliente sceglie il servizio.
Poi in ITIL troviamo le metriche di tempo: design cycle time, acquire cycle time, building cycle, transition cycle e velocità di ripristino. Nel KMM le grandezze corrispondenti sono lead time e cycle time, che si leggono come percentili sulle rispettive curve di distribuzione.
Cosa ITIL 5 dice sul livello operativo
ITIL 5 fornisce la cornice concettuale, il modello di ciclo di vita e i principi guida per orientare le decisioni, e lascia il dettaglio delle procedure operative ad altre fonti: le ITIL Practice Guide ufficiali, DevOps, PRINCE2 per il project management. Lo stesso ITIL dichiara che nessun framework da solo basta. Tratta anche il flusso, con la mappatura dei flussi del valore, e usa le metriche di tempo per individuare colli di bottiglia e ritardi.
Su Kanban dice due cose. Lo definisce come un metodo per visualizzare il lavoro, individuare blocchi e conflitti di risorse e gestire il lavoro in corso. E cita le Kanban board tra gli strumenti per dare visibilità agli stakeholder. Non compaiono né il funzionamento pull né i limiti al lavoro in corso. A mio avviso la rappresentazione che ITIL offre di Kanban è semplificata, come già scrivevo a proposito di ITIL 4: il metodo è molto più ricco.
Io propongo Kanban per governare e gestire i flussi. Per governare i flussi intendo applicare le pratiche e i principi del metodo Kanban, come specificati nel Kanban Maturity Model. Nel KMM il verbo governare si riferisce alle policy, che regolano il comportamento di persone e team, mentre il flusso di lavoro si gestisce. Io uso i due verbi insieme: le policy governano, e il lavoro scorre e si gestisce dentro quei confini.
Dalle metriche alla pratica
Prendiamo per esempio i rilasci andati male. In ITIL si misura il numero e l’impatto degli errori di transizione. In Kanban ragioniamo per work item, che attraversano il flusso. Se un work item arriva al rilascio e il rilascio va male, viene conteggiato e nasce un nuovo work item, marcato come failure demand: un rifacimento di qualcosa che era già stato fatto. Così facendo sappiamo in ogni momento quanta percentuale complessiva del lavoro è costituita da rilavorazioni.
Quanto possono pesare in percentuale le rilavorazioni? In Kanban: Successful Evolutionary Change for Your Technology Business, David Anderson riporta il caso di un team che spendeva il 90% della capacità disponibile nella correzione di difetti. Un flusso così è intasato da lavoro che nasce da lavoro già fatto male, e le nuove richieste aspettano.
Nelle organizzazioni più mature le rilavorazioni contano contro il limite del lavoro in corso: se ce ne sono troppe, non entra nuovo lavoro finché i problemi di qualità non sono stati risolti. I dati su difetti e rilavorazioni si guardano poi nelle revisioni periodiche, dove si decide cosa fare per ridurli.
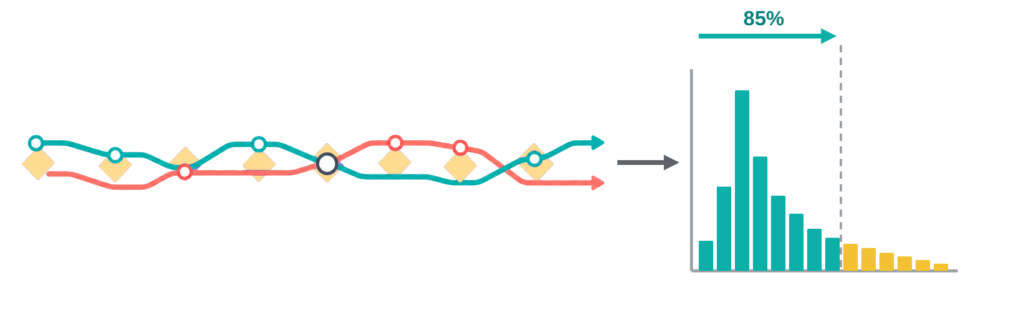
Passiamo alla performance rispetto agli SLA concordati. In Kanban lo SLA si costruisce partendo dai dati: si misurano i lead time dei lavori consegnati e se ne costruisce la curva di distribuzione. Dalla curva si leggono i percentili e, in base al percentile opportuno, si definisce la service level expectation (SLE): entro quanti giorni consegno e in quale percentuale di casi. L’85° percentile è il riferimento abituale, ma non è una regola: se un ritardo costa molto, conviene salire. Sulla base dello SLE definito si concorda lo SLA con il cliente in modo realistico.
Le metriche di tempo che ITIL associa alle attività, cioè design cycle time, acquire cycle time, building cycle e transition cycle, misurano ciascuna un singolo passaggio. ITIL ha poi una misura dell’intero flusso del valore, il lead time, dall’avvio alla consegna, e indica le otto attività come un buon punto di partenza per mappare i flussi. ITIL non dice però da dove parta il lead time.
Il KMM lo precisa, e parla dello stesso oggetto: quello che ITIL chiama flusso del valore, nel KMM è il workflow. Il customer lead time parte dalla richiesta accettata del cliente, il system lead time dalla presa in carico del lavoro da parte del team, ed entrambi arrivano alla consegna. Quando si applica Kanban si misurano sia le metriche end to end sia quelle dei singoli passaggi, e anche le attese, e in base a queste misure si ragiona su come ottimizzare il flusso.
Un passaggio può avere un buon tempo di ciclo e il cliente aspettare comunque a lungo, perché nel tempo di ciclo non ci sono le attese tra un passaggio e l’altro. L’esperienza dice che le attese sono la parte prevalente del lead time, e di diversi casi ho scritto anche su questo blog. Per questo si lavora sulle attese: limitando il lavoro in corso, riducendo code e buffer, gestendo meglio blocchi e dipendenze.
Lo stesso vale per la velocità di ripristino del servizio, che in ITIL compare in Support. È il lead time della gestione degli incidenti, e come ogni altra metrica di tempo si misura con la distribuzione, si legge con i percentili e si trasforma in uno SLE.
Resta la soddisfazione di stakeholder, clienti e utenti, che ITIL misura in tutte e otto le attività. Nel KMM non la si misura chiedendola in astratto. Si parte dai criteri con cui il cliente decide se richiedere il servizio, o dalle fonti della sua insoddisfazione, e da lì si ricavano gli indicatori da misurare: tempi di consegna per classe di servizio, quota di richieste consegnate senza rilavorazione, costo.
È quello che facciamo in continuazione con le aziende con cui collaboro. Partiamo dalle fonti di insoddisfazione, che mi raccontano i clienti. Quando abbiamo messo a posto il servizio, verifichiamo se quelle fonti sono state risolte. Gli indicatori non sono necessariamente solo quelli classici di Kanban: dalle fonti di insoddisfazione possono emergere altri aspetti da misurare, e li misuriamo. In questo modo la fitness for purpose diventa la sintesi di tutte le metriche, classiche e no.
L’intelligenza artificiale: dove serve e dove no
ITIL 5 dedica molto spazio all’intelligenza artificiale, e la collega alla visione olistica e all’individuazione dei colli di bottiglia. Dice anche di concentrare i miglioramenti del flusso proprio sui colli di bottiglia, e di ottimizzare il flusso prima di automatizzarlo. È un buon punto di partenza.
Una volta definito il flusso, si misura e si individua il collo di bottiglia, ed è lì che va applicata l’AI. Se la si applica a monte, il lavoro si accumula davanti al collo di bottiglia e il lead time peggiora. Se la si applica a valle, il lead time non cambia in modo apprezzabile, e può essere anche uno spreco: si accelera una stazione di lavoro che è già più scarica del collo di bottiglia. Prendiamo uno sviluppo software: se l’AI fa scrivere il codice più in fretta, ma il collo di bottiglia, a monte, è la risposta del cliente sui requisiti poco chiari, il lavoro accelerato resta in attesa. Non è cambiato nulla.
C’è poi un secondo ragionamento. Spesso il lavoro è fatto per lo più di attese, e accelerare il lavoro effettivo, come fa l’AI quando velocizza un compito, cambia poco il lead time. Ne ho scritto in un articolo recente, e lì la domanda diventa un’altra: come usare l’AI per ridurre le attese.
Conclusione
Sono partito da ITIL 5, che dice cosa misurare per ciascuna attività del ciclo di vita e rimanda ad altre fonti per il dettaglio operativo. Io propongo Kanban per governare e gestire i flussi, e le metriche sono il punto da cui si comincia. I rilasci andati male diventano failure demand, gli SLA nascono dalla distribuzione dei lead time, la soddisfazione si ricava dalle fonti di insoddisfazione di chi usa il servizio, e le metriche di tempo si leggono su tutto il flusso, non solo su un singolo passaggio.
Anche per l’intelligenza artificiale vale lo stesso ragionamento: serve dove c’è il collo di bottiglia, non dove il lavoro è già veloce. E resta necessario qualcuno che gestisca il sistema di lavoro, AI compresa.
Bibliografia
ITIL® Foundation, Version 5, manuale ufficiale, e ITIL® (Versione 5) Glossario principale, v5.1, luglio 2026, PeopleCert.
David J. Anderson, Teodora Bozheva, Kanban Maturity Model: A Map to Organizational Agility, Resilience, and Reinvention, 2nd Edition, Kanban University Press, 2021.
David J. Anderson, Kanban: Successful Evolutionary Change for Your Technology Business, Blue Hole Press, 2010.
Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti. Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.
Nell’articolo precedente ho raccontato come prendere le misure a un fornitore lento: misurare io il tempo che passa tra la mia richiesta e la sua risposta, quella che chiamo ‘metrica reciproca’, e regolarmi di conseguenza. Chiudevo con un’osservazione: il livello di servizio che dichiaro a valle deve tenere conto di quello che so del mio fornitore.
Resta però una domanda: quale livello di servizio dichiaro, io? Perché a valle il fornitore sono io. E il mio cliente, che io mi misuri o no, prima o poi la metrica reciproca la prende a me. Esattamente come io l’ho presa al mio fornitore.
Prendere le misure a me stesso
Quando un cliente chiede “per quando?”, di solito si tende a rispondere con una stima. Si guarda il lavoro, si valuta quanto è complicato, si pensa a com’è andata l’ultima volta e si ipotizza una data. È un’opinione, magari esperta, ma resta un’opinione. Una previsione funziona in un altro modo: non guarda il singolo lavoro, guarda come sono andati tutti i lavori simili. Non è un’opinione, è statistica.
Per fare questo lo strumento lo conosciamo già: è la stessa curva di distribuzione del Lead Time che ho costruito per il fornitore, solo che questa volta riguarda la parte del servizio che gestisco io. Con un’avvertenza su cosa misurare, perché è qui che ci si inganna più facilmente.
Il Kanban Maturity Model (KMM) distingue il Customer Lead Time, che parte da quando il cliente fa la richiesta, dal System Lead Time, che parte da quando io la prendo in carico. In mezzo c’è l’attesa all’ingresso: la richiesta è arrivata, ma nessuno ci sta ancora lavorando. Quell’attesa tendo a non vederla, perché per me il lavoro non è ancora cominciato. Il cliente invece la subisce per intero. Se misuro solo il System Lead Time, la mia previsione è strutturalmente ottimistica e il cliente aspetta sistematicamente più di quanto dicano i miei dati.
“I dati non li abbiamo”
Quando ne parlo nelle aziende arriva quasi sempre un’obiezione: “bello, ma i dati non li abbiamo”. In realtà ci sono quasi sempre, solo che non vengono usati. Ogni lavoro chiuso ha lasciato una traccia: una data in cui è stato chiesto e una in cui è stato consegnato, in un sistema di ticketing, in una mail, in un registro, a volte in un foglio Excel che qualcuno compila per abitudine. Non servono strumenti sofisticati per cominciare, serve la disciplina di raccogliere i dati. E, come abbiamo visto nel precedente articolo, se il sistema è stabile una trentina di misurazioni bastano per avere un primo quadro affidabile.
“Ma ogni lavoro è diverso”
La seconda obiezione che ricevo in azienda è più radicata: “il nostro lavoro non si presta, ogni cliente ha esigenze uniche, ogni progetto è un caso a sé”. È vero solo in parte. Il lavoro davvero unico esiste, ma è molto meno di quanto ci piace pensare. Il resto è fatto di attività che ripetiamo ogni settimana, solo che non le tracciamo, e quello che non vediamo ci sembra imprevedibile per definizione.
Di solito il lavoro non è tutto diverso: è di pochi tipi diversi. E i dati, curiosamente, lo mostrano da soli. Il KMM osserva che quando la distribuzione del Lead Time ha più picchi, in genere è perché dentro ci sono più tipi di lavoro mescolati. La risposta, quindi, non è rinunciare a misurare perché “tanto è tutto diverso”, ma separare i dati per tipo e costruire una curva per ciascuno. Tre o quattro tipi di lavoro diventano tre o quattro distribuzioni, e tre o quattro previsioni, ognuna sufficientemente affidabile per il suo tipo.
Dalla distribuzione allo SLE
Dalla distribuzione nasce il livello di servizio che posso dichiarare al cliente, lo SLE (Service Level Expectation): entro quanto tempo consegno, e in quale percentuale di casi. Perché sia una promessa e non un azzardo, però, servono due condizioni.
La prima è che la coda sia sottile, cioè che il rapporto tra il 98° percentile e la mediana stia sotto 5,6. Se la coda è grassa, qualunque numero dichiari è fragile: prima o poi arriva il caso che va lunghissimo e smentisce tutto. In quella situazione il primo lavoro non è promettere, è accorciare la coda statistica.
La seconda è scegliere il percentile giusto. L’85° è il riferimento comune per i servizi, sei volte su sette, ma non è una regola che vale sempre. Dipende da quanto costa al cliente un ritardo: se il ritardo costa molto, conviene salire.
Distribuzione del Lead Time dell’onboarding dopo il primo mese
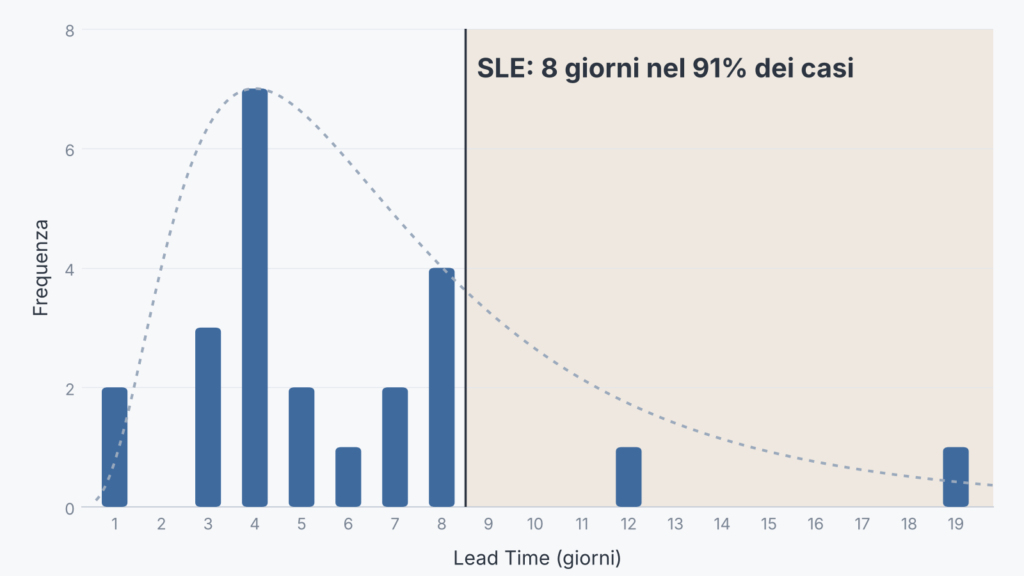
Un buon esempio di quanto descritto è il caso dell’onboarding di Grow, di cui parlo nell’articolo Migliora le tue risorse umane con Kanban: Kanban in HR – Scaling Kanban in an HR department at Grow (Italy) (case study in inglese). Quando abbiamo cominciato a misurare, il Lead Time andava da 1 a 96 giorni: una coda grassa, su cui nessuna promessa poteva essere affidabile. Non abbiamo dichiarato niente. Siamo intervenuti su uno dei colli di bottiglia, la firma digitale del contratto, e in un mese la coda si è accorciata fino a diventare sottile (19 giorni), con una distribuzione dei tempi di onboarding come nell’immagine. Solo a quel punto abbiamo dichiarato ai reparti richiedenti uno SLE: 8 giorni nel 91% dei casi.
Abbiamo tenuto il percentile più alto dell’85° perché un ritardo nell’onboarding non era un semplice disagio: significava persone al lavoro senza un contratto firmato, con il rischio di sanzioni. Lo stesso servizio, con un costo del ritardo più basso, avrebbe potuto reggersi su un percentile diverso.
Cosa vuole davvero il cliente
Si pensa spesso che il cliente voglia tutto e subito, e che l’unico modo per farlo contento sia promettere tempi brevi. In realtà quello che spesso cerca è un’altra cosa: risposte oneste e previsioni affidabili, con cui fare a sua volta le sue previsioni.
È il meccanismo dell’articolo precedente, visto dall’altra parte del tavolo. Il mio SLE diventa il dato su cui il mio cliente pianifica, esattamente come lo SLE del mio fornitore era il dato su cui pianificavo io. Una data detta con sicurezza, che poi slitta, magari più volte, non gli serve a niente: lo costringe a ripianificare ogni volta. Una previsione affidabile con una probabilità dichiarata invece gli permette di regolarsi. La catena regge solo se ogni anello è onesto e affidabile, e io sono uno degli anelli.
Conclusione
Non è vero, quindi, che non posso promettere niente di affidabile. Come minimo posso misurarmi, con gli stessi strumenti con cui misuro il fornitore, e sapere cosa posso dichiarare. Posso separare i tipi di lavoro invece di nascondermi dietro il “è tutto diverso”, accorciare la coda dove serve prima di promettere, e scegliere il percentile in base a quanto costa davvero un ritardo. E posso dare al mio cliente esattamente quello che io chiedo al mio fornitore: una previsione onesta.
Al giorno d’oggi, poi, c’è una nuova tentazione, più forte che mai: usare l’AI e lasciare che sia lei a fare le previsioni al posto nostro. Ma se il lavoro non è tracciato, l’AI una risposta la dà comunque, sicura e ben presentata, solo che non ha fondamento. È una stima come quella descritta più sopra, ma quando esce da un sistema automatico con un numero e un grafico, smette di sembrare un’opinione e nessuno la mette più in discussione. Decidere cosa misurare e come resta una scelta umana, come ho spiegato nell’articolo Perché collegare l’AI ai vostri dati di flusso non basta.
Quest’ultimo tema è così importante che ho deciso di dedicargli un podcast, che prenderà il via il prossimo mese di novembre. Restate sintonizzati!
Bibliografia
David J. Anderson, Teodora Bozheva, Kanban Maturity Model: A Map to Organizational Agility, Resilience, and Reinvention – 2nd Edition, Kanban University Press, 2021
Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti. Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.
Una frase che mi capita spesso di sentire è più o meno questa: “Noi potremmo organizzarci meglio e rendere prevedibile il nostro lavoro, ma i tempi di certe operazioni dipendono dagli altri. Non possiamo farci niente.”
Ogni volta che l’ho sentita ho pensato che avrei dovuto scrivere questo articolo. Perché non è vero che non ci si può fare niente: si può fare qualcosa, e anche di abbastanza semplice.
Chiamo fornitore chiunque debba fare qualcosa per me senza che io ne abbia il controllo. Può essere un’azienda esterna, ma anche un collega di un’altra funzione.
Prima di tutto, misurare
Se dipendo da qualcuno che ci mette tanto tempo, la prima cosa da capire è cosa vuol dire quel “tanto”. Se il fornitore non mi dà le sue metriche, le prendo io: è quella che chiamo ‘metrica reciproca’. Misuro il tempo che passa da quando faccio la richiesta a quando ricevo la risposta, e lo faccio abbastanza a lungo da costruire una curva di distribuzione del Lead Time.
Non servono migliaia di dati. Se il fenomeno è consistente, cioè se i tempi restano più o meno sempre nello stesso range, siamo in quello che Taleb chiama Mediocristan. Il Kanban Maturity Model (KMM) offre una regola pratica per verificarlo: il rapporto tra il 98° percentile e la mediana deve stare sotto 5,6. In quel caso una trentina di misurazioni bastano per avere un quadro piuttosto affidabile.
Abbastanza spesso, a misure prese, scopro una cosa banale: il fornitore non è imprevedibile, è semplicemente più lento di quanto dichiara. E lo è in modo costante.
Decidere con i dati
Il riferimento abituale è l’85° percentile: sei volte su sette la risposta arriva entro quel tempo. Il KMM definisce il Lead Time proprio così: se so quando mi serve la consegna, il Lead Time è l’anticipo con cui devo fare l’ordine per aspettarmi di riceverla in tempo.
A questo punto confronto quel valore con il tempo di cui ho bisogno. Se la risposta mi serve più in là dell’85° percentile, la richiesta va in classe di servizio standard: la mando con il giusto anticipo e so che, storicamente, arriverà in tempo. È inutile sollecitare, ed è inutile sorprendersi ogni volta dei tempi lunghi. Li conosco.
Se invece mi serve prima, il rischio di andare lunghi è più alto di quello che posso permettermi, e la richiesta va segnalata come urgente. Più il tempo è stretto, più il rischio è alto, e la distribuzione mi dice esattamente quanto. L’urgenza però deve restare un’eccezione: se tutto arriva urgente, il fornitore smette di crederci. Per questo conviene giocare d’anticipo il più possibile.
Provare a pressare e poi misurare di nuovo
“Va bene, ma allora come facciamo?” A questo punto posso fare un esperimento: pressare il fornitore e vedere cosa succede alla distribuzione. Se si comprime e l’85° percentile rientra nel tempo che mi serve, ho trovato un pattern su cui contare: il pressing diventa strutturale e lo faccio di default. Se non si comprime, ho comunque imparato che quella leva non funziona.
In ogni caso devo continuare a misurare, perché il pressing cambia il sistema. E devo tenere a mente che, se i miei tempi si accorciano, forse sto solo passando davanti agli altri clienti del fornitore: io miglioro, il suo sistema no.
Le misure servono anche a valle. Se a mia volta devo garantire dei tempi a un cliente, interno o esterno, il mio livello di servizio atteso (SLE – Service Level Expectation) deve tenere conto di quello che so del mio fornitore. È inutile promettere cose che so già di non poter mantenere a causa di qualcun altro.
Un caso reale
Con un fornitore con cui c’è una buona collaborazione dovevamo chiudere un progetto. Il fornitore dichiarava di poter finire entro fine febbraio, e per farcela avrebbe dovuto rilasciare circa nove work item a settimana. Gli abbiamo preso le misure, ricostruendole da progetti passati: ne rilasciava tre, in modo piuttosto stabile.
Non potevamo triplicare il suo Throughput, così abbiamo triplicato il tempo e pianificato la consegna per fine aprile. A lui abbiamo continuato a indicare fine febbraio. Abbiamo misurato il Throughput e non il Lead Time, ma con un sistema stabile vale la Legge di Little e il risultato non cambia: circa tre mesi.
Il progetto si è chiuso, come previsto, a fine aprile. La scadenza più stretta non ha accelerato nulla: il fornitore ha tenuto il suo ritmo. Noi però siamo arrivati puntuali, perché avevamo pianificato sui suoi numeri e non sulle sue dichiarazioni.
Successivamente ho condiviso con lui, in modo trasparente, cosa avevamo misurato e cosa avevamo fatto. E lui ha cambiato approccio.
Conclusione
Quindi no, non è vero che non posso farci niente. Come minimo posso misurare, e sapere cosa posso promettere a mia volta. Poi posso giocare d’anticipo, sperimentare il pressing e vedere se cambia qualcosa. E posso portare i dati al fornitore, perché il suo sistema può migliorarlo solo lui.
David J. Anderson, Teodora Bozheva, Kanban Maturity Model: A Map to Organizational Agility, Resilience, and Reinvention – 2nd Edition, Kanban University Press, 2021
Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti. Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.
Quando mi chiedono che lavoro faccio, e chi me lo chiede non ha chiaro perché serva un consulente per migliorare i flussi di lavoro, parto sempre dall’efficienza di flusso.
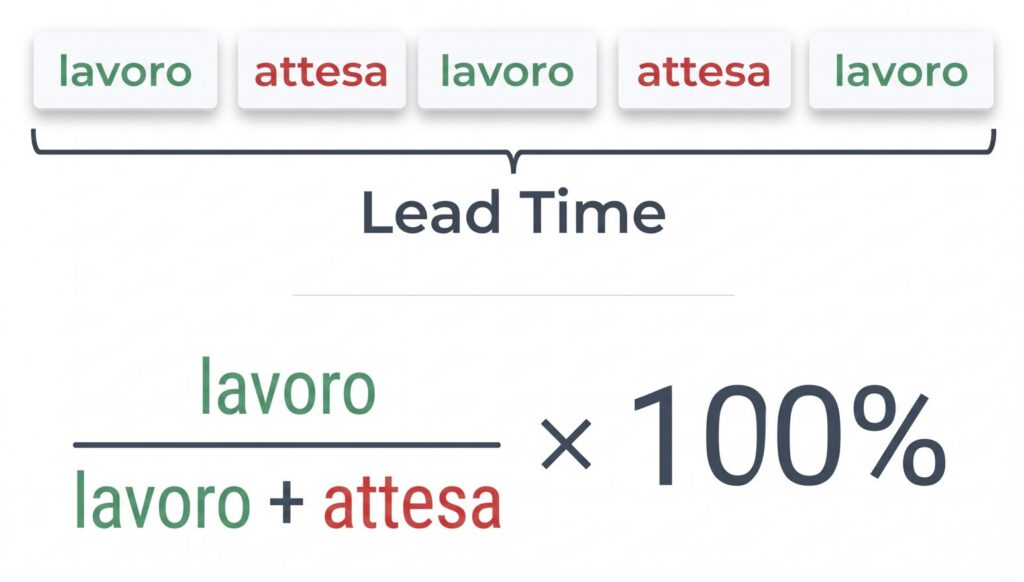
L’efficienza di flusso è il rapporto tra il tempo in cui si lavora effettivamente a un’attività e il tempo totale che passa dall’inizio alla fine di quella stessa attività, cioè il Lead Time. Nella pratica, di solito non si usa come indicatore operativo, perché non è semplice da calcolare. Si usano le pratiche del metodo Kanban, le quali, come risultato, aumentano l’efficienza di flusso. Comprenderne la dinamica, pur senza calcolarla, permette comunque di afferrare il senso del metodo Kanban.
Quando l’efficienza di flusso è bassa, cioè sotto il 15% secondo il Kanban Maturity Model (KMM), il margine di miglioramento sta soprattutto nell’eliminare i tempi di attesa. Il che si ottiene limitando il lavoro in corso, riducendo code e buffer e gestendo meglio problemi bloccanti e dipendenze, tutte pratiche Kanban. Anderson ne ha parlato in un recente keynote, che ho sintetizzato in un articolo. Qui voglio riprendere e approfondire questo specifico aspetto.
Il lavoro effettivo è inizialmente solo una piccola parte del tempo
Il Toyota Production System, precursore del metodo Kanban, ha messo al centro proprio questo: non far andare più veloci gli addetti all’assemblaggio dei veicoli, ma eliminare le attese che stanno intorno al lavoro vero e proprio.
Nel lavoro di concetto, knowledge work in inglese, il ragionamento è identico, con una differenza. La materia prima è l’informazione. Se si parte senza averla tutta e questa arriva un po’ per volta, ci si ferma ad aspettarla, si riparte, ci si ferma di nuovo.
Prendiamo lo sviluppo software. Si comincia a sviluppare e a un certo punto manca un requisito del cliente, perché non era chiaro in fase di analisi. Si chiede al cliente, poi ci si ferma e si aspetta. Quando si ha la risposta, si riprende a lavorare fino a quando si incappa in un altro requisito poco chiaro e ci si ferma di nuovo. E così via. Alla fine il software è pronto, lo si consegna al cliente per il test e si resta in attesa del suo feedback. Se si sommano le attese, nell’esperienza mia e di molti colleghi della community Kanban, queste costituiscono la parte largamente prevalente del Lead Time.
Andare più veloci non è la leva
Per questo, all’inizio di una consulenza, una delle prime cose su cui lavoro è smontare l’idea, diffusa, che l’efficienza si ottenga facendo lavorare più in fretta le persone.
Il punto è controintuitivo. Limitare il lavoro in corso significa che le persone si occupano di meno cose contemporaneamente. Nella mia esperienza questo le porta a ricavarsi il tempo per riflettere su come tagliare i tempi morti, e dopo un po’ il processo va più veloce, senza che nessuno debba affannarsi. Nelle organizzazioni di cui parlo nei miei case study ho visto riduzioni del Lead Time fino al 90%, risultati che sono analoghi a quelli riscontrati da colleghi della community.
Cosa c’entra l’intelligenza artificiale
A più di un lettore può essere venuto a questo punto il dubbio: ma cosa c’entra questo ragionamento con l’intelligenza artificiale? Oggi, nel lavoro di concetto, l’AI viene usata soprattutto per la produttività personale. Aiuta a scrivere un testo, a fare calcoli, a preparare un’analisi, a sviluppare codice, e ognuno di questi compiti si svolge più in fretta.
Ma applicare l’AI a queste attività risponde alla stessa logica del far andare più veloci le persone. Accelera il lavoro effettivo, che è la parte più piccola del Lead Time.
Un esempio numerico: supponiamo che il lavoro effettivo sia il 10% del Lead Time, quindi due giorni su venti, e che l’AI lo dimezzi. Il lavoro passa a un giorno, il Lead Time a diciannove giorni, con un miglioramento del 5%. Il 10% è un’ipotesi esemplificativa, in linea con una situazione sotto la soglia del 15% del KMM, che è l’ordine di grandezza da cui partono i casi che seguo. Il dimezzamento del lavoro effettivo è generoso, per cui nella realtà il miglioramento è probabilmente inferiore.
A fronte di un miglioramento di questa entità, il costo dell’AI può essere anche rilevante, come riferito nel keynote da Anderson. Tornando all’esempio del software: se l’AI fa scrivere il codice più in fretta, il collo di bottiglia resta la risposta del cliente, e il problema non è risolto.
Serve un uso sistemico dell’intelligenza artificiale
La domanda giusta è come si potrebbe usare l’AI per ridurre le attese, che sono ciò che incide davvero sul Lead Time. Personalmente, un uso sistemico di questo tipo non l’ho ancora visto.
Se e quando lo troveremo, otterremo più valore dall’investimento. Anche questo ragionamento conferma però un tema che ho già sollevato in miei articoli precedenti: serve qualcuno che pensi a come gestire il sistema di lavoro e gli strumenti, l’AI compresa. Questo compito non viene eliminato dall’intelligenza artificiale, e continua a essere necessario come lo è sempre stato.
Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti. Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.
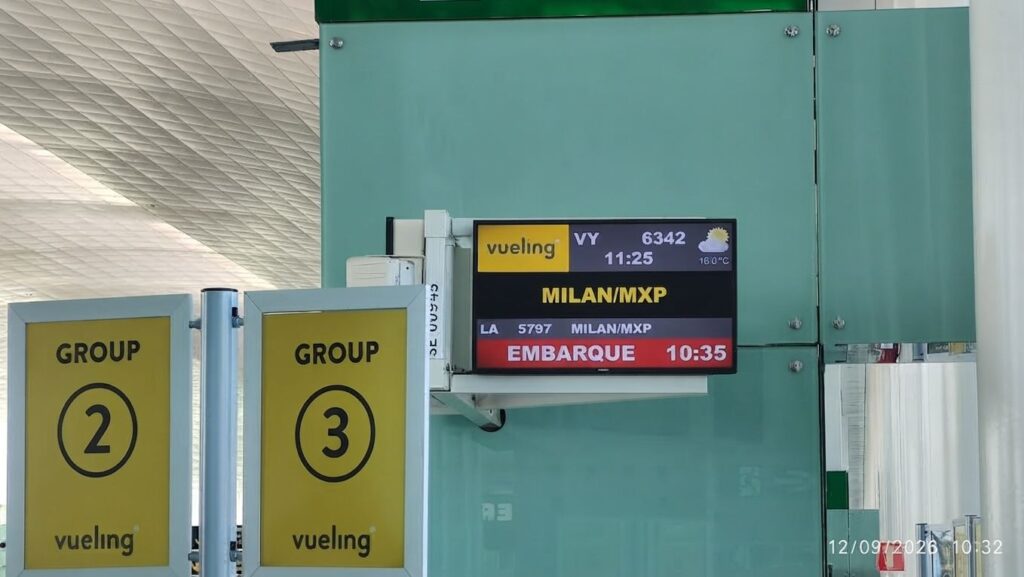
Tornando dal Kanban Leadership Retreat di Bilbao ho volato con Vueling, sulle tratte Bilbao-Barcellona e Barcellona-Milano. Due imbarchi e due sbarchi, sempre con la stessa gestione del flusso. Cito la compagnia perché è quella che ho potuto osservare, non perché sia l’unica. Qui voglio soffermarmi su cosa possiamo imparare da questo modo di gestire il flusso dei passeggeri, per applicarlo ai flussi di lavoro delle nostre organizzazioni.
Il vincolo: una sola porta
In tutti e quattro i casi l’aereo era attraccato al pontile, il cosiddetto finger. In questa situazione si usa solo la porta anteriore e quella posteriore resta chiusa. Per i passeggeri è più comodo, perché si resta sempre all’interno, non si cammina mai in pista e non ci si bagna se piove.
Imbarco e sbarco però sono normalmente più lenti, perché tutti passano da una sola porta. Se chi ha la fila 26 si trova dietro a chi ha la fila 4, deve fermarsi finché l’altro non si è seduto, perché non c’è spazio per proseguire. In termini Kanban, la porta è il collo di bottiglia del sistema.
Diventa quindi fondamentale l’ordine di imbarco. Le compagnie da sempre chiamano per numero di fila, ma i passeggeri fanno un po’ quello che vogliono. Qualcuno arriva con la fila sbagliata e viene messo da parte, ma non si sottilizza troppo, e all’imbarco si crea di solito parecchia confusione.
All’imbarco: corsie, cartelli e gruppi
Nei gate che ho usato, Vueling divide i passeggeri in tre gruppi, anteriore, centrale e posteriore. È un sistema semplice, come si fa nel metodo Kanban, senza niente di sofisticato. Il numero del gruppo, 1, 2 o 3, è stampato sulla carta d’imbarco.
Al gate le transenne a nastro, le cosiddette bindelle, creano tre corsie di coda, ciascuna con il suo cartello. Le persone si mettono quasi spontaneamente nella corsia giusta. Si imbarca il gruppo 1, poi il 2, poi il 3, e il gruppo successivo viene chiamato quando il precedente è sostanzialmente imbarcato.
Non è molto diverso da quello che si è sempre fatto, ma creando le corsie e mettendo i cartelli si gestisce davvero il flusso, e l’ingresso in aereo risulta molto più ordinato. Ritrovo la visualizzazione (corsie e cartelli), una policy esplicita (il gruppo sulla carta d’imbarco), il limite al lavoro in corso (si imbarca un gruppo alla volta) e il pull (il gruppo successivo viene chiamato quando il precedente ha finito).
Io ero nel gruppo 3, perché avevo preso la tariffa più economica. Quando sono salito, i gruppi 1 e 2, cioè circa due terzi dell’aereo, erano già seduti e il corridoio era libero. Andare in fondo e sedersi è stato molto più semplice. È successo sia a Bilbao sia a Barcellona.
Allo sbarco: un sistema simile
Ho fatto due sbarchi, a Barcellona e a Milano. Di solito, quando l’aereo arriva all’attracco, tutti i passeggeri saltano in piedi e cominciano a tirare fuori i bagagli dalle cappelliere. Qui invece parte un annuncio abbastanza perentorio: restare seduti al proprio posto fino a quando non si viene chiamati.
Poi si chiamano blocchi di file, partendo dalle più avanti, dalla 1 alla X e poi dalla X+1 alla Y. Non ricordo quante file avesse ogni blocco. Il personale tiene monitorato il deflusso e, quando il blocco è pronto a uscire, chiama il successivo. L’uscita risulta più ordinata e più rapida.
Anche qui ritrovo una policy esplicita (restare seduti), il limite al lavoro in corso (un blocco alla volta) e il pull, con il segnale che arriva da valle, cioè dal corridoio che si sta liberando. Sono due sistemi diversi ma simili e governati dalle stesse logiche di gestione del flusso: uno per l’imbarco, uno per lo sbarco.
Le misure
Sono rimasto favorevolmente impressionato, perché è un esempio semplice di come un accorgimento facile da implementare possa migliorare un flusso. La mia sensazione è che il tempo di imbarco e sbarco si sia ridotto sensibilmente. Non ho fatto misure, perché l’idea dell’articolo mi è venuta dopo il viaggio, quindi non ho né i tempi né il numero di file per gruppo di imbarco o blocco di sbarco. In ogni caso le mie misure non sarebbero state significative come statistica.
Le compagnie aeree le misure le fanno di sicuro. Hanno tempi stretti per sbarcare, imbarcare e non perdere lo slot di decollo, come detto chiaramente negli annunci che mi è capitato di sentire altre volte per sollecitare i passeggeri a sbrigarsi a prendere posto. Non so cosa misurino esattamente, ma suppongo che tra le misure ci siano il tempo tra l’apertura delle porte e lo sbarco completo, e il tempo tra l’apertura del gate e la chiusura delle porte.
Suppongo anche che il sistema sia stato ottimizzato: con una sola porta, in pochi minuti l’aereo era pronto a partire.
Cosa portarsi a casa
Per i nostri flussi di lavoro la lezione è la stessa: rendere visibile il flusso, esplicitare le regole e far entrare il lavoro a blocchi, chiamando il successivo solo quando il precedente sta defluendo. Nel vostro sistema, in base a cosa si decide quando il blocco successivo può partire?
Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti. Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.
Sono appena rientrato dal Kanban Leadership Retreat, la tre giorni annuale organizzata per la propria comunità da Kanban University. Tra i temi che hanno occupato più spazio quest’anno c’era l’AI: dove sta già cambiando il modo di lavorare di manager e knowledge worker e come il metodo Kanban possa aiutare le organizzazioni a orientarsi in un contesto tecnologico che si muove molto in fretta.
La risposta che sembra corretta finché non fate due volte la stessa domanda
Prendo spunto da una sessione proposta da Sonya Siderova, fondatrice di Nave, dedicata a flow metrics, analytics e AI agent. La domanda di partenza era semplice da porre ma non di facile risposta: che cosa succede quando si toglie la persona, lo human in the loop, dal ciclo di gestione del flusso di lavoro e si lascia decidere all’AI? Gli argomenti condivisi dal gruppo di lavoro sono stati sei: costo più elevato, difficoltà ad adattarsi a condizioni che cambiano, perdita di competenza di management, perdita di capacità di fare le domande giuste, perdita di capacità di guidare il cambiamento, perdita di gestione delle pratiche operative. Nel confronto tra un agente AI da solo e un agente affiancato da una persona, l’agente da solo non basta su nessuno di questi sei punti, nemmeno se lavora interfacciandosi con un motore di flow analytics già maturo.
Peggio ancora se l’agente accede direttamente ai dati grezzi di flusso e li elabora in autonomia. Il riscontro, dai test effettuati, è che si ottiene una risposta plausibile ma non affidabile. Il valore che l’AI aggiunge sta altrove: accedere attraverso il protocollo MCP ai dati prodotti in modo affidabile dal motore di flow analytics e costruirci sopra una narrazione, arrivando a generare raccomandazioni.
L’esempio che descrive è preciso. Qualcuno collega un LLM ai dati grezzi di flusso e chiede quanto dura normalmente un lavoro, cosa sta rallentando un team, quando saranno finiti quaranta work item. In pochi minuti arriva una risposta, e sembra che il problema sia risolto. Tre mesi dopo qualcuno rifà la stessa domanda. Nel frattempo il team ha cambiato workflow, due stati sono stati rinominati, i difetti seguono un percorso diverso. L’AI restituisce un numero diverso, e a quel punto nessuno sa più dire quale risposta fosse corretta.
Il prototipo non è la parte difficile
Siderova anticipa l’obiezione più ovvia, quella di chi ha collegato i propri dati grezzi di flusso a un LLM, ha sviluppato una demo e pensa di aver già risolto tutto: collegare l’API di strumenti quali Jira o Azure DevOps a un modello di AI non è al giorno d’oggi particolarmente difficile. La parte difficile comincia dopo la demo.
Prendete il cycle time. Dove parte il timer, alla creazione del ticket, all’ingresso in backlog o all’inizio effettivo del lavoro? Cosa succede se il work item torna indietro? Se salta uno stato? Se viene riaperto? Il tempo di attesa conta o no? Sono decisioni di misurazione, non domande che si rivolgono all’AI. Qualcuno deve prenderle, e poi assicurarsi che continuino a valere quando il workflow cambia il mese successivo, e quello dopo ancora. L’integrazione è un progetto, con un inizio e una fine. Il modello di misurazione è un prodotto: ha bisogno di un owner, di test, di manutenzione continua.
Da qui le sei domande che Siderova invita a porsi su ogni sistema, prima di fidarsi di un suo qualsiasi numero, che si tratti di uno strumento interno, di un foglio di calcolo o di una piattaforma commerciale: dove parte il cycle time, dove finisce, cosa succede quando il lavoro torna indietro, cosa succede quando un work item salta direttamente a “Fatto”, cosa succede quando un lavoro completato viene riaperto, il tempo di attesa viene conteggiato? E ne aggiunge una settima, decisiva quando quei numeri servono a prendere un impegno su una data di consegna: si sta guardando una media, o un percentile che permette davvero di valutare il rischio? Se il sistema non permette di rispondere con chiarezza a queste domande, quei numeri non possono essere usati per un impegno su una data di consegna. Un numero plausibile e un numero affidabile sono due cose diverse.
Interfaccia, non motore di calcolo
Interrogare ogni volta i dati grezzi e lasciare che sia l’LLM a interpretarli da zero è il modo più veloce per avere una risposta, ed è però anche quello che produce il problema descritto sopra, una risposta diversa ogni volta che qualcosa a monte cambia, senza che nessuno se ne accorga finché i numeri smettono di tornare. Interrogare un motore di flow analytics che applica sempre le stesse definizioni perché configurato opportunamente, con l’AI solo come interfaccia, fornisce invece risposte affidabili: la stessa domanda, posta oggi o tra sei mesi, produce una risposta diversa solo se sono cambiati i dati di flusso sottostanti, non perché è cambiata l’interpretazione di quei dati.
Non è un problema di modello di AI più o meno capace, è che le definizioni di misura non sono pattern che un LLM possa indovinare guardando i dati, sono decisioni che qualcuno deve avere già preso a monte.
Non è un problema di AI
Qui il discorso torna alla sostanza della gestione del flusso di lavoro. Dove parte il timer, come si trattano gli stati, cosa succede se c’è una rilavorazione: non sono un problema di ownership tecnica dello strumento. Sono esattamente ciò che rende maturo un sistema Kanban: policy esplicite, confini del workflow dichiarati, non lasciati all’intuito di chi in quel momento guarda la board. Un’organizzazione che non ha mai reso esplicite queste regole non scopre un problema di AI quando i numeri smettono di tornare. Scopre un problema di sistema che aveva sempre avuto, e che l’AI si limita a rendere visibile più in fretta, perché moltiplica il numero di domande poste a un sistema che non era pronto a rispondere con coerenza.
Ed è per questo motivo che trattare lo human in the loop come un tema separato dalla qualità della misurazione è fuorviante. Sono lo stesso tema visto da due lati diversi. La persona che possiede le definizioni di misurazione deve anche restare la persona che le mantiene quando il workflow cambia. Non è un ruolo che l’AI rende superfluo. Diventa anzi più necessario proprio perché l’AI abbassa il costo di fare domande al sistema.
Il punto di leva resta lo stesso di sempre
Visualizzare il flusso. Limitare il lavoro in corso. Rendere esplicite le policy, comprese quelle di misurazione che di solito nessuno scrive perché sembrano ovvie finché il numero torna. Solo dentro un sistema costruito così ha senso collegare un’AI e farsi rispondere sui propri dati di flusso di lavoro. Solo così quello che si ottiene è una risposta, oltre che plausibile, di cui ci si possa fidare.
Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti. Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.
Cookie Consent
Privacy e cookie: questo sito utilizza cookie tecnici e, previo tuo consenso, cookie di statistica e di marketing (statistiche di visita, pulsanti di condivisione, video).
Puoi accettarli o rifiutarli. Per saperne di più leggi l’Informativa su privacy e cookie.
Gestisci qui di seguito le tue preferenze relative ai cookie:
I cookie essenziali consentono il funzionamento delle funzioni di base e sono necessari per il corretto funzionamento del sito web.
Nome
Descrizione
Durata
Preferenze dei Cookie
Questo cookie viene utilizzato per memorizzare le preferenze dell'utente relative al consenso all'uso dei cookie.
30 days
Questi cookie sono necessari per poter pubblicare commenti su questo sito web.
Nome
Descrizione
Durata
comment_author_email
Memorizza i dati inseriti nel modulo commenti per precompilarlo nelle visite successive.
Sessione
comment_author_url
Memorizza i dati inseriti nel modulo commenti per precompilarlo nelle visite successive.
Sessione
I cookie statistici raccolgono informazioni in forma anonima. Queste informazioni ci aiutano a capire come i visitatori utilizzano il nostro sito web.
Funzionalità di analisi dei visitatori integrata in Jetpack. Registra le visualizzazioni delle pagine, i siti di provenienza, i termini di ricerca e i clic sui link in uscita, e include anche la libreria condivisa di tracciamento dei visitatori utilizzata da Jetpack Instant Search e WooCommerce Analytics.
Memorizza un ID visitatore anonimo generato in modo casuale, in modo che la libreria di analisi Tracks di Jetpack possa associare gli eventi di tracciamento allo stesso visitatore.
Sessione in wp-admin; fino a 5 anni sul front-end
tk_qs
Mette in coda gli eventi di analisi per la libreria Tracks di Jetpack, in modo che nessuno vada perso se la pagina viene chiusa prima che possano essere inviati.
30 minuti
tk_tc
Viene utilizzato una volta per ogni caricamento della pagina per determinare quale dominio dei cookie debba utilizzare la libreria Tracks, per poi essere rimosso non appena viene letto.
Sessione (cancellato immediatamente dopo l'uso)
tk_aip
Memorizza un elenco di ID dei visitatori anonimi in modo che possano essere uniti in un'unica identità una volta che il visitatore viene riconosciuto.
Fino a 5 anni
I cookie di marketing vengono utilizzati per tracciare i visitatori dei siti web. Lo scopo è quello di mostrare annunci pubblicitari pertinenti e interessanti per il singolo utente.
AddToAny mette a disposizione pulsanti di condivisione e di "Segui" che consentono ai visitatori di pubblicare le tue pagine sui social network, sulle app di messaggistica e sui servizi di salvataggio dei segnalibri.
Imposta il dominio addtoany.com per ricordare quali servizi di condivisione utilizza il visitatore, in modo che il menu di condivisione li elenchi per primi.
9999 giorni
Una piattaforma di condivisione video che consente agli utenti di caricare, visualizzare e condividere video di vari generi e argomenti.
Registra un ID univoco sui dispositivi mobili per consentire il tracciamento in base alla posizione geografica rilevata dal GPS.
1 giorno
VISITOR_INFO1_LIVE
Cerca di stimare la larghezza di banda degli utenti sulle pagine che contengono video di YouTube integrati. Viene utilizzato anche a fini di marketing
179 giorni
PREF
Questo cookie memorizza le tue preferenze e altre informazioni, in particolare la lingua preferita, il numero di risultati di ricerca che desideri visualizzare sulla pagina e se desideri o meno che il filtro SafeSearch di Google sia attivato.
10 anni dalla creazione/dall'aggiornamento
YSC
Registra un ID univoco per tenere traccia dei video di YouTube che l'utente ha visualizzato.
Sessione
DEVICE_INFO
Viene utilizzato per verificare se il visitatore ha accettato la categoria “marketing” nel banner dei cookie. Questo cookie è necessario per garantire la conformità del sito web al GDPR.
179 giorni
LOGIN_INFO
Questo cookie viene utilizzato per riprodurre i video di YouTube incorporati nel sito web.
2 anni
VISITOR_PRIVACY_METADATA
Cookie relativi ai metadati sulla privacy dei visitatori di YouTube
180 giorni
Per ulteriori informazioni, consulta la nostra informativa su Privacy e Cookie.