Perché collegare l’AI ai vostri dati di flusso non basta: le decisioni che qualcuno deve prendere

Sono appena rientrato dal Kanban Leadership Retreat, la tre giorni annuale organizzata per la propria comunità da Kanban University. Tra i temi che hanno occupato più spazio quest’anno c’era l’AI: dove sta già cambiando il modo di lavorare di manager e knowledge worker e come il metodo Kanban possa aiutare le organizzazioni a orientarsi in un contesto tecnologico che si muove molto in fretta.
La risposta che sembra corretta finché non fate due volte la stessa domanda

Prendo spunto da una sessione proposta da Sonya Siderova, fondatrice di Nave, dedicata a flow metrics, analytics e AI agent. La domanda di partenza era semplice da porre ma non di facile risposta: che cosa succede quando si toglie la persona, lo human in the loop, dal ciclo di gestione del flusso di lavoro e si lascia decidere all’AI? Gli argomenti condivisi dal gruppo di lavoro sono stati sei: costo più elevato, difficoltà ad adattarsi a condizioni che cambiano, perdita di competenza di management, perdita di capacità di fare le domande giuste, perdita di capacità di guidare il cambiamento, perdita di gestione delle pratiche operative. Nel confronto tra un agente AI da solo e un agente affiancato da una persona, l’agente da solo non basta su nessuno di questi sei punti, nemmeno se lavora interfacciandosi con un motore di flow analytics già maturo.

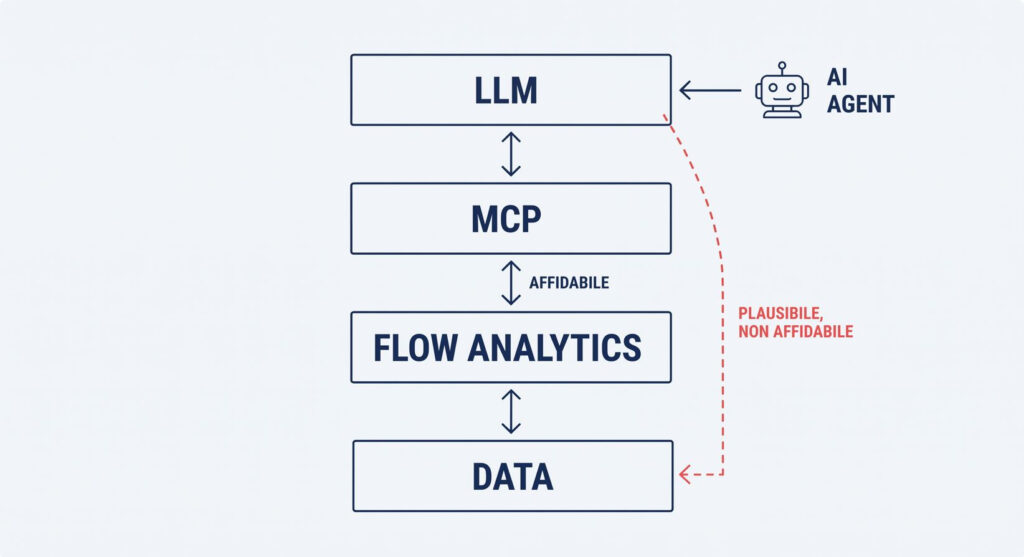
Peggio ancora se l’agente accede direttamente ai dati grezzi di flusso e li elabora in autonomia. Il riscontro, dai test effettuati, è che si ottiene una risposta plausibile ma non affidabile. Il valore che l’AI aggiunge sta altrove: accedere attraverso il protocollo MCP ai dati prodotti in modo affidabile dal motore di flow analytics e costruirci sopra una narrazione, arrivando a generare raccomandazioni.

Successivamente a quella sessione, Siderova ha ripreso e sviluppato il ragionamento in un articolo che trovate su LinkedIn: https://www.linkedin.com/pulse/your-ai-can-talk-delivery-data-you-trust-answer-sonya-siderova-rfdfe

L’esempio che descrive è preciso. Qualcuno collega un LLM ai dati grezzi di flusso e chiede quanto dura normalmente un lavoro, cosa sta rallentando un team, quando saranno finiti quaranta work item. In pochi minuti arriva una risposta, e sembra che il problema sia risolto. Tre mesi dopo qualcuno rifà la stessa domanda. Nel frattempo il team ha cambiato workflow, due stati sono stati rinominati, i difetti seguono un percorso diverso. L’AI restituisce un numero diverso, e a quel punto nessuno sa più dire quale risposta fosse corretta.

Il prototipo non è la parte difficile

Siderova anticipa l’obiezione più ovvia, quella di chi ha collegato i propri dati grezzi di flusso a un LLM, ha sviluppato una demo e pensa di aver già risolto tutto: collegare l’API di strumenti quali Jira o Azure DevOps a un modello di AI non è al giorno d’oggi particolarmente difficile. La parte difficile comincia dopo la demo.

Prendete il cycle time. Dove parte il timer, alla creazione del ticket, all’ingresso in backlog o all’inizio effettivo del lavoro? Cosa succede se il work item torna indietro? Se salta uno stato? Se viene riaperto? Il tempo di attesa conta o no? Sono decisioni di misurazione, non domande che si rivolgono all’AI. Qualcuno deve prenderle, e poi assicurarsi che continuino a valere quando il workflow cambia il mese successivo, e quello dopo ancora. L’integrazione è un progetto, con un inizio e una fine. Il modello di misurazione è un prodotto: ha bisogno di un owner, di test, di manutenzione continua.

Da qui le sei domande che Siderova invita a porsi su ogni sistema, prima di fidarsi di un suo qualsiasi numero, che si tratti di uno strumento interno, di un foglio di calcolo o di una piattaforma commerciale: dove parte il cycle time, dove finisce, cosa succede quando il lavoro torna indietro, cosa succede quando un work item salta direttamente a “Fatto”, cosa succede quando un lavoro completato viene riaperto, il tempo di attesa viene conteggiato? E ne aggiunge una settima, decisiva quando quei numeri servono a prendere un impegno su una data di consegna: si sta guardando una media, o un percentile che permette davvero di valutare il rischio? Se il sistema non permette di rispondere con chiarezza a queste domande, quei numeri non possono essere usati per un impegno su una data di consegna. Un numero plausibile e un numero affidabile sono due cose diverse.

Interfaccia, non motore di calcolo

Interrogare ogni volta i dati grezzi e lasciare che sia l’LLM a interpretarli da zero è il modo più veloce per avere una risposta, ed è però anche quello che produce il problema descritto sopra, una risposta diversa ogni volta che qualcosa a monte cambia, senza che nessuno se ne accorga finché i numeri smettono di tornare. Interrogare un motore di flow analytics che applica sempre le stesse definizioni perché configurato opportunamente, con l’AI solo come interfaccia, fornisce invece risposte affidabili: la stessa domanda, posta oggi o tra sei mesi, produce una risposta diversa solo se sono cambiati i dati di flusso sottostanti, non perché è cambiata l’interpretazione di quei dati.

Non è un problema di modello di AI più o meno capace, è che le definizioni di misura non sono pattern che un LLM possa indovinare guardando i dati, sono decisioni che qualcuno deve avere già preso a monte.

Non è un problema di AI

Qui il discorso torna alla sostanza della gestione del flusso di lavoro. Dove parte il timer, come si trattano gli stati, cosa succede se c’è una rilavorazione: non sono un problema di ownership tecnica dello strumento. Sono esattamente ciò che rende maturo un sistema Kanban: policy esplicite, confini del workflow dichiarati, non lasciati all’intuito di chi in quel momento guarda la board. Un’organizzazione che non ha mai reso esplicite queste regole non scopre un problema di AI quando i numeri smettono di tornare. Scopre un problema di sistema che aveva sempre avuto, e che l’AI si limita a rendere visibile più in fretta, perché moltiplica il numero di domande poste a un sistema che non era pronto a rispondere con coerenza.

Ed è per questo motivo che trattare lo human in the loop come un tema separato dalla qualità della misurazione è fuorviante. Sono lo stesso tema visto da due lati diversi. La persona che possiede le definizioni di misurazione deve anche restare la persona che le mantiene quando il workflow cambia. Non è un ruolo che l’AI rende superfluo. Diventa anzi più necessario proprio perché l’AI abbassa il costo di fare domande al sistema.

Il punto di leva resta lo stesso di sempre

Visualizzare il flusso. Limitare il lavoro in corso. Rendere esplicite le policy, comprese quelle di misurazione che di solito nessuno scrive perché sembrano ovvie finché il numero torna. Solo dentro un sistema costruito così ha senso collegare un’AI e farsi rispondere sui propri dati di flusso di lavoro. Solo così quello che si ottiene è una risposta, oltre che plausibile, di cui ci si possa fidare.

Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti.
Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.

L’A3 Thinking nelle cadenze Kanban: risolvere i problemi giusti nel modo giusto

Ogni organizzazione ha riunioni. Poche organizzazioni hanno riunioni che cambiano davvero qualcosa.

Il metodo Kanban prevede un sistema di cadenze – incontri ricorrenti con scopi precisi – progettate per mantenere il flusso di lavoro sotto controllo e far evolvere il sistema nel tempo. Ma c’è un rischio concreto: senza un approccio strutturato al problem solving, le cadenze diventano sessioni di aggiornamento in cui si osservano i problemi senza capirli e risolverli davvero.

L’A3 Thinking è uno strumento che trasforma questo rischio in un’opportunità.

Single-loop e double-loop learning: due modi di imparare

Immagina un termostato. Quando la temperatura scende sotto la soglia impostata, accende il riscaldamento. Quando la raggiunge, si spegne. Il termostato corregge l’errore in modo efficiente, ma non si chiede mai se la temperatura impostata sia quella giusta per chi vive in quella casa.

Questo è il single-loop learning: si rileva uno scarto tra il risultato atteso e quello ottenuto, e si corregge il comportamento. È utile, necessario, e costituisce la base di quasi tutto il miglioramento operativo. Un team che analizza il proprio Lead Time, identifica un collo di bottiglia e modifica un limite WIP sta facendo single-loop learning e lo sta facendo bene.

Il double-loop learning aggiunge una domanda diversa: non “come correggiamo lo scarto?” ma “perché abbiamo impostato quella temperatura?” Nel contesto organizzativo, significa mettere in discussione i modelli mentali e i presupposti che stanno dietro al sistema, non solo le sue regole operative. Non “come gestiamo meglio le urgenze?” ma “la nostra definizione di urgenza riflette davvero le priorità del cliente? Il servizio che stiamo ottimizzando è ancora quello giusto da offrire?”

Nel Kanban Maturity Model, questa distinzione ha un peso preciso. I livelli da ML1 a ML5 si muovono nel territorio del single-loop learning: l’organizzazione impara progressivamente a fare meglio quello che già fa, gestire il flusso, ridurre la variabilità, coordinare servizi interdipendenti. È al livello ML6 che il double-loop learning emerge pienamente, quando l’organizzazione sviluppa la capacità di interrogarsi sulle quattro domande fondamentali: Come lavoriamo è ancora competitivo? Cosa offriamo è ancora rilevante? Perché esistiamo ha ancora senso nel mercato attuale? Chi siamo è ancora adeguato al contesto?

Perché è importante chiarirlo prima di parlare di A3 Thinking? Perché l’A3 è uno strumento potente per il single-loop learning strutturato e questo non è poco. Trasforma le cadenze Kanban da sessioni di aggiornamento in motori di apprendimento sistematico. Ma il suo contributo al double-loop learning, quando arriva, non riguarda la gestione dei blocchi o l’ottimizzazione del Lead Time: riguarda la capacità di usare i dati del sistema per mettere in discussione la direzione stessa dell’organizzazione.

Il Kanban Maturity Model: un’evoluzione per livelli

Il Kanban Maturity Model (KMM) articola la crescita organizzativa in sei livelli e l’A3 Thinking non è rilevante allo stesso modo per tutti i livelli.

Ai livelli ML1 e ML2, dove il lavoro dipende ancora dagli individui e dal loro buon senso, mancano ancora le basi – dati affidabili, policy esplicite, cultura del feedback – per usarlo efficacemente. È a partire da ML3, quando l’organizzazione arriva a gestire il lavoro come un vero sistema end-to-end, che l’A3 diventa uno strumento di evoluzione reale, ed è ai livelli superiori che esprime tutto il suo potenziale come motore di single-loop learning strutturato, costruendo le fondamenta su cui, a ML6, può emergere il double-loop learning.

Cos’è l’A3 Thinking (e come si usa nelle cadenze Kanban)

L’A3 Thinking è un metodo di problem solving sviluppato in Toyota. Il nome viene dal foglio di carta formato A3: l’idea originale era che un problema – dalla descrizione alla soluzione – dovesse stare tutto su un singolo foglio. Non per superficialità, ma per disciplina. È una forma di slow thinking, pensiero lento e profondo: se non riesci a sintetizzare un problema su una pagina, probabilmente non lo hai ancora capito abbastanza bene.

Il template si compone di cinque sezioni, distribuite su un foglio A3 o su fronte e retro di un foglio A4.

Definizione del problema. Prima ancora di cercare soluzioni, bisogna capire cosa si sta osservando e perché conta. Nelle cadenze di revisione periodica – la Service Delivery Review o la Risk Review – questa è la domanda di apertura: qual è il gap tra la performance attuale del servizio e quello che il cliente si aspetta? Definire bene il problema in questa fase evita di sprecare energie su sintomi invece che su cause.

Analisi del problema. È la sezione più importante, e quella più spesso saltata. L’analisi non si fa a parole, ma con i dati di flusso: quanto tempo impiega mediamente un elemento di lavoro ad attraversare il sistema? Dove si accumula? Quanto tempo passa in attesa rispetto al tempo in cui qualcuno ci sta lavorando davvero? Il modo più efficace per rispondere a queste domande non è scrivere una lista di osservazioni, ma incollare direttamente sul foglio A3 i grafici che raccontano la storia: un Cumulative Flow Diagram (CFD) che mostra dove il lavoro si accumula, un grafico di Lead Time che rivela la variabilità del sistema, un aging chart che evidenzia cosa è fermo da troppo tempo. L’A3 non è un documento di testo con qualche numero: è uno strumento visivo, e la differenza si vede.

Nelle cadenze operative – il Kanban Meeting quotidiano – questa mentalità analitica serve a leggere i blocchi non come eccezioni da risolvere in fretta, ma come segnali che raccontano qualcosa sul sistema. La domanda non è “chi lo sblocca?”, ma “perché si è bloccato?”.

Esperimento e piano di implementazione. Una volta identificata la causa, si progetta un intervento – non una soluzione definitiva, ma un esperimento. Questa distinzione è importante: un esperimento ha un’ipotesi verificabile (“se modifichiamo il limite di lavoro in corso in questo punto, il tempo di attraversamento dovrebbe ridursi”), mentre una soluzione è spesso solo un’opinione con più autorevolezza. Il piano di implementazione definisce chi fa cosa, in quale cadenza si osserveranno i risultati, e quali metriche si useranno per giudicare se l’esperimento ha funzionato. Un esperimento per volta, altrimenti non si riesce a capire cosa ha funzionato e che cosa no.

Risultati dell’esperimento. La cadenza naturale per questa sezione è la Service Delivery Review: si torna sui dati dopo un ciclo sufficiente a produrre segnale, e si misura l’effetto reale dell’intervento. Anche qui, i risultati non si raccontano a parole: si mostrano. Lo stesso grafico usato nell’analisi, aggiornato dopo l’esperimento, dice immediatamente se qualcosa è cambiato e in che direzione. Se il Lead Time si è stabilizzato, il CFD mostra bande più uniformi, se si è ridotto l’aging chart ha meno elementi in zona critica. La continuità visiva tra analisi e risultati è parte del metodo: rende evidente il confronto e riduce lo spazio per le interpretazioni di comodo. Questo passaggio è quello che trasforma un’opinione in apprendimento. Senza di esso, il sistema non impara, accumula solo iniziative.

Prossimi passi. Se l’esperimento ha funzionato, il risultato non è “problema risolto” ma “nuova policy da codificare”. Una regola di ingresso rivista, un criterio di priorità esplicitato, una soglia di allerta definita. È qui che il cambiamento smette di dipendere dalla memoria delle persone e diventa parte del sistema. Se invece l’esperimento non ha prodotto i risultati attesi, i prossimi passi riportano all’analisi con nuove informazioni.

Questa struttura ciclica è ciò che distingue l’A3 da una normale checklist: non si compila una volta, si percorre più volte, ciascuna con una comprensione più profonda del problema.

Il problema che l’A3 risolve nelle cadenze Kanban

Nelle organizzazioni ai livelli ML1 e ML2, i problemi vengono ancora affrontati in modo reattivo: è single-loop learning, ma applicato in modo caotico e inconsapevole, senza che l’organizzazione ne tragga apprendimento stabile.

Il salto verso ML3 non è un salto verso il double-loop learning: è il passaggio a un single-loop learning maturo, strutturato e consapevole. L’A3 Thinking può supportare questo passaggio spostando il focus dalle persone al sistema. La domanda non è “chi ha sbagliato?” ma “cosa nel nostro modo di lavorare produce questo risultato?” È una distinzione che Deming aveva reso famosa decenni fa, e che ancora oggi fatica a entrare nella cultura di molte aziende.

Ai livelli ML4 e ML5, quando le decisioni si basano su modelli probabilistici e il miglioramento si estende oltre i confini del singolo team, l’A3 consolida questo percorso: aiuta a orchestrare il miglioramento tra servizi interdipendenti, a gestire il rischio in modo strutturato, a rendere l’apprendimento operativo una pratica normale e non un evento eccezionale. Sempre nell’ambito del single-loop learning, ma portato alla sua massima maturità, come preparazione al salto qualitativo che avviene a ML6.

Dall’analisi alla policy: il cambiamento che rimane

Un problema risolto una volta non è un problema risolto. Lo è solo quando la soluzione viene codificata in una regola esplicita che il sistema segue anche quando chi ha trovato la soluzione non c’è più.

L’A3 Thinking, in questo percorso, è uno strumento che aiuta a costruire le fondamenta. Senza la disciplina del single-loop learning strutturato – senza la capacità di analizzare, sperimentare e codificare – il double-loop rimane un esercizio intellettuale senza radici operative. Le organizzazioni che arrivano a ML6 non saltano i livelli precedenti: li attraversano, e l’A3 è parte di come lo fanno.

Una nota finale

W. Edwards Deming diceva che l’apprendimento non è obbligatorio, così come non lo è la sopravvivenza. L’A3 Thinking nelle cadenze Kanban non è una tecnica sofisticata riservata alle organizzazioni avanzate. È il modo in cui si fa sul serio con il miglioramento continuo a partire da ML3: guardare i dati, capire il sistema, cambiare le regole. E ricominciare.

Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti.
Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.