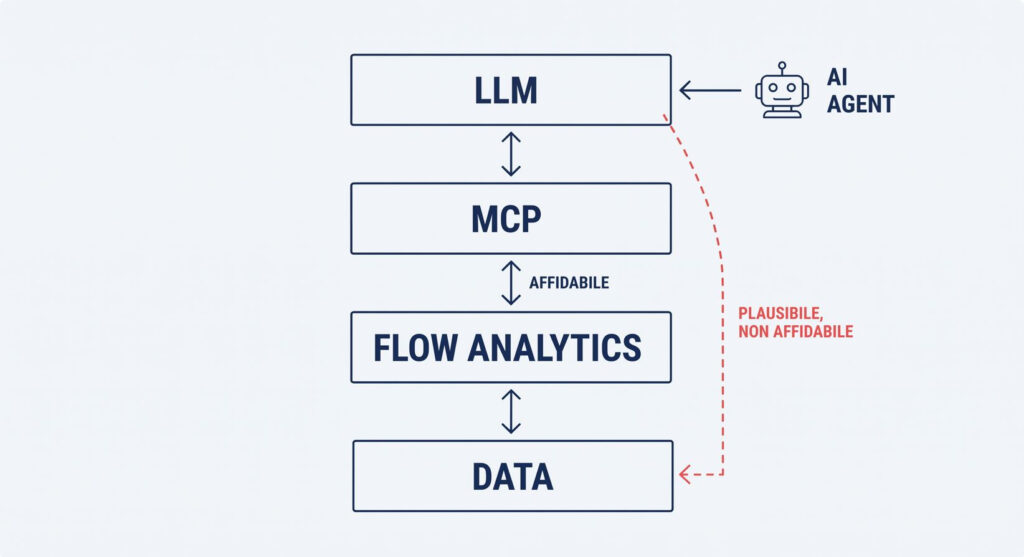
Al ritorno dal Kanban Leadership Retreat, ho scritto un articolo, “Perché collegare l’AI ai vostri dati di flusso non basta: le decisioni che qualcuno deve prendere”, su un tema che al retreat aveva occupato molto spazio: qual è la corretta architettura per introdurre l’AI in un sistema Kanban. La conclusione era che un agente AI da solo non basta, e che le cose vanno peggio se accede direttamente ai dati grezzi di flusso e li elabora in autonomia. Si ottiene una risposta plausibile ma non affidabile, che cambia quando cambia il workflow senza che nessuno se ne accorga.
Il ruolo giusto per l’AI è quello di interfaccia di un motore di flow analytics, che applica sempre le stesse definizioni di misura, con una persona (lo human in the loop) che quelle definizioni le ha decise e le mantiene. Nelle ultime settimane abbiamo applicato questa architettura a un lavoro vero: il Rolling Forecast dei progetti collegato al sistema Kanban di un’organizzazione.
Lo scenario: come funziona il Rolling Forecast
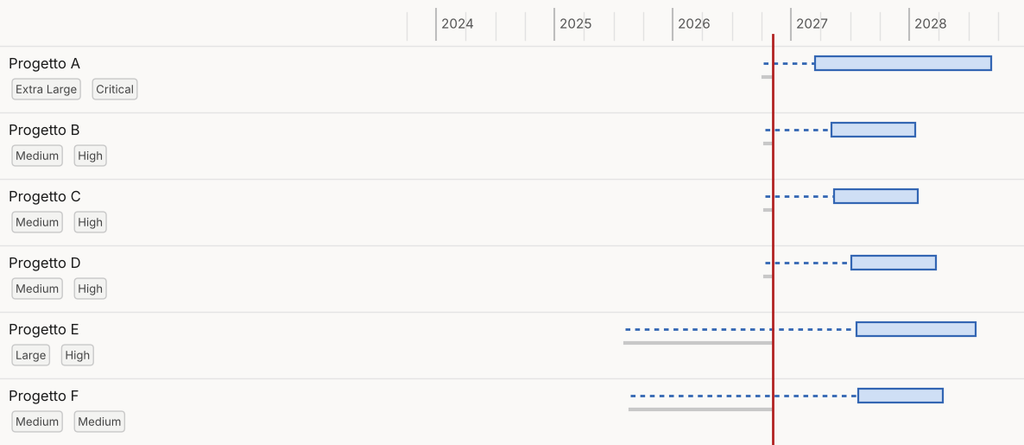
Il Rolling Forecast, del quale ho già parlato nell’articolo “Oltre il Gantt: il Rolling Forecast per introdurre Kanban e una pianificazione dinamica orientata al flusso”, permette di pianificare i progetti rispettando il limite di lavoro in corso e la capacità disponibile. Se la capacità non c’è, il progetto slitta in avanti, a volte anche all’anno successivo. Le date che ne escono vengono poi riportate sulle card della Kanban board, come inizio e scadenza.
Nel caso specifico su cui abbiamo lavorato, il Rolling Forecast è collegato a un sistema Kanban di portfolio progetti e ne recepisce le policy. Ogni progetto ha una taglia assegnata, e la durata attesa si ricava dall’85° percentile dei progetti già completati della stessa taglia. I progetti in coda si ordinano per priorità, poi per scadenza, poi per ordine di arrivo. Un progetto parte quando c’è capacità, ovvero un posto libero nei limiti al lavoro in corso, sia quello complessivo sia quelli delle singole persone assegnate. Quando un progetto finisce, il posto si libera e il successivo può partire. Il risultato è per ogni progetto una data di inizio e una di fine attese, che si ricalcolano quando cambiano i dati.
Due motori, un’AI e una persona
L’architettura nel nostro caso ha due motori. Il primo è il sistema Kanban in cui il lavoro è gestito, basato su Kanban Zone, che gestisce il flusso, raccoglie gli eventi e restituisce dati puliti: date di ingresso e uscita dalle colonne, taglie dei progetti, assegnatari. È lui il motore di flow analytics di cui parlavo nell’articolo precedente.
Il secondo motore non esisteva e l’abbiamo creato: un motore di calcolo del Rolling Forecast. Legge i dati del sistema Kanban e fa il forecast di pianificazione in funzione della capacità disponibile. Avremmo potuto chiedere il Rolling Forecast direttamente all’AI, che lo avrebbe dato per approssimazione statistica, ma non lo abbiamo fatto. Invece ci siamo fatti aiutare dall’AI a costruire un motore algoritmico, come il sistema Kanban, che faccia i calcoli corretti. Le regole che usa, cioè il percentile per ogni taglia, l’ordine in coda e i limiti per persona, sono scritte in un file di configurazione che chiunque può leggere. Non sono nascoste nella testa di chi pianifica, e non dipendono da come un’AI interpreta i dati.
Accanto a ogni regola il file indica da dove viene: dalla board, dal lavoro di pianificazione già esistente, oppure da un’ipotesi. Chi ha la responsabilità del sistema può quindi leggere una regola, discuterla, cambiarla, e il motore ricalcola applicandola sempre allo stesso modo. Sopra i due motori lavorano l’AI e la persona, con compiti diversi: li descrivo nella sezione successiva.
Chi fa cosa
I due motori calcolano, sempre allo stesso modo sugli stessi dati. Se un numero cambia, è perché sono cambiati i dati o è cambiata una regola scritta, mai perché qualcuno ha interpretato i dati in modo diverso. L’AI non calcola. Confronta i dati e gli output dei due motori, mette in evidenza le incongruenze e aiuta a riconoscere i pattern che in un elenco lungo non si vedono a occhio. La persona decide le regole e analizza l’esito del confronto.
Rispetto all’articolo precedente c’è un elemento in più, che è opportuno tenere distinto. L’AI ha scritto il codice del secondo motore, e la persona l’ha controllato e testato sulla board, verificando che l’output fosse quello previsto dalle regole.
Cosa è emerso
Il confronto fatto dall’AI sui dati dei due motori ha fatto emergere alcune domande che fino a quel momento erano rimaste implicite. Alcuni esempi danno bene l’idea di come funziona.
Il primo riguarda il momento in cui finisce il progetto. Un progetto completato, poi riaperto e chiuso di nuovo, risultava con due durate molto diverse a seconda di quale chiusura si considerava. Il motore di calcolo del Rolling Forecast ne sceglieva una per convenzione, e l’AI ha messo in evidenza l’incongruenza del dato. Cosa significhi “finito” per un lavoro che torna indietro è una policy di processo, e la scelta spetta a una persona.
Il secondo riguarda i limiti per persona. La policy della board fissa un numero massimo di progetti per ciascuna persona, ma non dice cosa fare quando un progetto è assegnato a più persone. Il motore di calcolo del Rolling Forecast ha bisogno di una regola per prevedere, e nella configurazione è stato necessario scriverne una, che per ora resta un’ipotesi: un progetto condiviso vale per ciascuno una frazione, da definire. L’AI ha messo in evidenza l’incongruenza tra ciò che la policy dice e ciò che il calcolo richiede. Completare la policy spetta a una persona.
Il terzo riguarda la durata attesa, che si ricava dal percentile dei progetti già completati della stessa taglia. Qui le incongruenze erano più d’una: i valori che avevamo ipotizzato inizialmente e quelli misurati non coincidevano per alcune taglie, il percentile si spostava molto a causa di pochi progetti lunghi, e due taglie quasi non si distinguevano per durata. Su quale base calcolare un valore su cui impegnarsi è una decisione ancora aperta che spetta a una persona.
Il confronto serve a capire
L’analisi fatta con il supporto dell’AI mette in evidenza le incongruenze, di qualunque tipo siano, e lo fa individuando dei pattern che in un insieme articolato di dati difficilmente si vedono a occhio. Ma l’AI si ferma lì: segnala delle incongruenze e può suggerire dei perché.
Ogni incongruenza può avere più cause. Può mancare una policy che il motore non conosce, perché esiste già nella pratica ma nessuno l’ha mai scritta. Può non essere aggiornata la board. Oppure può servire una policy nuova, che finora nessuno aveva avuto bisogno di definire e che il calcolo ha reso necessaria. Capire quale sia la causa, e quindi cosa fare, è il compito della persona che conosce davvero il sistema. L’analisi fatta con il supporto dell’AI le dà il punto da cui partire per evolvere il sistema, e la comprensione resta della persona.
Solo dopo aver capito arrivano le decisioni: introdurre una nuova policy, completarne una esistente, aggiornare la board. Ogni decisione di questo tipo rende il funzionamento del sistema più coerente, e le esecuzioni successive dei motori lo riflettono.
Conclusione
Il caso mostra all’opera l’architettura di cui scrivevo nell’articolo precedente: i motori calcolano su dati puliti, l’AI confronta e individua i pattern, la persona capisce e decide. Le incongruenze emerse riguardano il funzionamento del flusso e le policy del sistema: dove finisce un progetto, come si conta un limite, su quale base si stima una durata. Sono emerse perché i motori applicano sempre le stesse regole e il calcolo ne richiede di esplicite. Rieseguiti sugli stessi dati, producono gli stessi output, e le stesse incongruenze restano visibili. Usando i dati grezzi un’AI avrebbe potuto notarne qualcuna, ma senza regole stabili a ogni domanda avrebbe potuto dare una risposta diversa.
C’è poi un’aggiunta rispetto all’articolo precedente, che riguarda un possibile uso dell’AI: l’AI ha abbassato il costo di costruire un pezzo di motore che mancava, lasciando però il controllo alla persona.
Ora i due motori girano insieme. A ogni esecuzione producono dati su cui l’AI individua i pattern, e la persona li usa per capire e migliorare il sistema.
Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti.
Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.