Sono appena rientrato dal Kanban Leadership Retreat, la tre giorni annuale organizzata per la propria comunità da Kanban University. Tra i temi che hanno occupato più spazio quest’anno c’era l’AI: dove sta già cambiando il modo di lavorare di manager e knowledge worker e come il metodo Kanban possa aiutare le organizzazioni a orientarsi in un contesto tecnologico che si muove molto in fretta.
La risposta che sembra corretta finché non fate due volte la stessa domanda
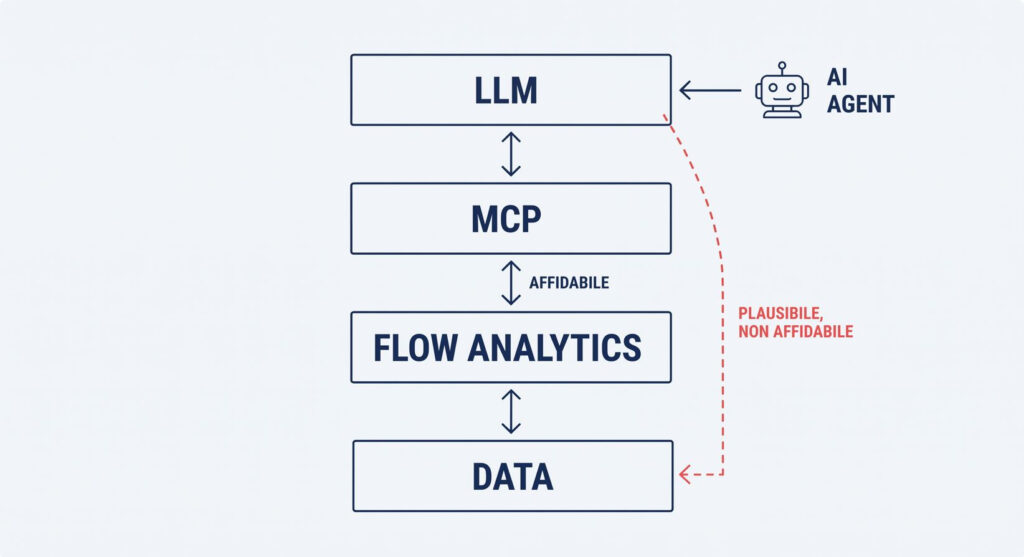
Prendo spunto da una sessione proposta da Sonya Siderova, fondatrice di Nave, dedicata a flow metrics, analytics e AI agent. La domanda di partenza era semplice da porre ma non di facile risposta: che cosa succede quando si toglie la persona, lo human in the loop, dal ciclo di gestione del flusso di lavoro e si lascia decidere all’AI? Gli argomenti condivisi dal gruppo di lavoro sono stati sei: costo più elevato, difficoltà ad adattarsi a condizioni che cambiano, perdita di competenza di management, perdita di capacità di fare le domande giuste, perdita di capacità di guidare il cambiamento, perdita di gestione delle pratiche operative. Nel confronto tra un agente AI da solo e un agente affiancato da una persona, l’agente da solo non basta su nessuno di questi sei punti, nemmeno se lavora interfacciandosi con un motore di flow analytics già maturo.
Peggio ancora se l’agente accede direttamente ai dati grezzi di flusso e li elabora in autonomia. Il riscontro, dai test effettuati, è che si ottiene una risposta plausibile ma non affidabile. Il valore che l’AI aggiunge sta altrove: accedere attraverso il protocollo MCP ai dati prodotti in modo affidabile dal motore di flow analytics e costruirci sopra una narrazione, arrivando a generare raccomandazioni.
Successivamente a quella sessione, Siderova ha ripreso e sviluppato il ragionamento in un articolo che trovate su LinkedIn: https://www.linkedin.com/pulse/your-ai-can-talk-delivery-data-you-trust-answer-sonya-siderova-rfdfe
L’esempio che descrive è preciso. Qualcuno collega un LLM ai dati grezzi di flusso e chiede quanto dura normalmente un lavoro, cosa sta rallentando un team, quando saranno finiti quaranta work item. In pochi minuti arriva una risposta, e sembra che il problema sia risolto. Tre mesi dopo qualcuno rifà la stessa domanda. Nel frattempo il team ha cambiato workflow, due stati sono stati rinominati, i difetti seguono un percorso diverso. L’AI restituisce un numero diverso, e a quel punto nessuno sa più dire quale risposta fosse corretta.
Il prototipo non è la parte difficile
Siderova anticipa l’obiezione più ovvia, quella di chi ha collegato i propri dati grezzi di flusso a un LLM, ha sviluppato una demo e pensa di aver già risolto tutto: collegare l’API di strumenti quali Jira o Azure DevOps a un modello di AI non è al giorno d’oggi particolarmente difficile. La parte difficile comincia dopo la demo.
Prendete il cycle time. Dove parte il timer, alla creazione del ticket, all’ingresso in backlog o all’inizio effettivo del lavoro? Cosa succede se il work item torna indietro? Se salta uno stato? Se viene riaperto? Il tempo di attesa conta o no? Sono decisioni di misurazione, non domande che si rivolgono all’AI. Qualcuno deve prenderle, e poi assicurarsi che continuino a valere quando il workflow cambia il mese successivo, e quello dopo ancora. L’integrazione è un progetto, con un inizio e una fine. Il modello di misurazione è un prodotto: ha bisogno di un owner, di test, di manutenzione continua.
Da qui le sei domande che Siderova invita a porsi su ogni sistema, prima di fidarsi di un suo qualsiasi numero, che si tratti di uno strumento interno, di un foglio di calcolo o di una piattaforma commerciale: dove parte il cycle time, dove finisce, cosa succede quando il lavoro torna indietro, cosa succede quando un work item salta direttamente a “Fatto”, cosa succede quando un lavoro completato viene riaperto, il tempo di attesa viene conteggiato? E ne aggiunge una settima, decisiva quando quei numeri servono a prendere un impegno su una data di consegna: si sta guardando una media, o un percentile che permette davvero di valutare il rischio? Se il sistema non permette di rispondere con chiarezza a queste domande, quei numeri non possono essere usati per un impegno su una data di consegna. Un numero plausibile e un numero affidabile sono due cose diverse.
Interfaccia, non motore di calcolo
Interrogare ogni volta i dati grezzi e lasciare che sia l’LLM a interpretarli da zero è il modo più veloce per avere una risposta, ed è però anche quello che produce il problema descritto sopra, una risposta diversa ogni volta che qualcosa a monte cambia, senza che nessuno se ne accorga finché i numeri smettono di tornare. Interrogare un motore di flow analytics che applica sempre le stesse definizioni perché configurato opportunamente, con l’AI solo come interfaccia, fornisce invece risposte affidabili: la stessa domanda, posta oggi o tra sei mesi, produce una risposta diversa solo se sono cambiati i dati di flusso sottostanti, non perché è cambiata l’interpretazione di quei dati.
Non è un problema di modello di AI più o meno capace, è che le definizioni di misura non sono pattern che un LLM possa indovinare guardando i dati, sono decisioni che qualcuno deve avere già preso a monte.
Non è un problema di AI
Qui il discorso torna alla sostanza della gestione del flusso di lavoro. Dove parte il timer, come si trattano gli stati, cosa succede se c’è una rilavorazione: non sono un problema di ownership tecnica dello strumento. Sono esattamente ciò che rende maturo un sistema Kanban: policy esplicite, confini del workflow dichiarati, non lasciati all’intuito di chi in quel momento guarda la board. Un’organizzazione che non ha mai reso esplicite queste regole non scopre un problema di AI quando i numeri smettono di tornare. Scopre un problema di sistema che aveva sempre avuto, e che l’AI si limita a rendere visibile più in fretta, perché moltiplica il numero di domande poste a un sistema che non era pronto a rispondere con coerenza.
Ed è per questo motivo che trattare lo human in the loop come un tema separato dalla qualità della misurazione è fuorviante. Sono lo stesso tema visto da due lati diversi. La persona che possiede le definizioni di misurazione deve anche restare la persona che le mantiene quando il workflow cambia. Non è un ruolo che l’AI rende superfluo. Diventa anzi più necessario proprio perché l’AI abbassa il costo di fare domande al sistema.
Il punto di leva resta lo stesso di sempre
Visualizzare il flusso. Limitare il lavoro in corso. Rendere esplicite le policy, comprese quelle di misurazione che di solito nessuno scrive perché sembrano ovvie finché il numero torna. Solo dentro un sistema costruito così ha senso collegare un’AI e farsi rispondere sui propri dati di flusso di lavoro. Solo così quello che si ottiene è una risposta, oltre che plausibile, di cui ci si possa fidare.
Ho pubblicato originariamente questo articolo per il portale Kanban Help, al quale collaboro insieme al collega Luca Gambetti.
Visita Kanban Help – www.kanban.help – per conoscere gli strumenti formativi e di coaching che ti possono aiutare a introdurre il metodo Kanban nella tua azienda.